Linux: Linux文本处理工具和正则表达式
- TAGS: Linux
摘要:本文介绍Linux文本处理工具和正则表达式
内容概述
- 文本编辑工具VIM
- 各种文本工具
- 基本正则表达式和扩展正则表达式
- 文本处理三剑客之grep
- 文本处理三剑客之sed
- 文本处理三剑客之awk
文本编辑工具之神VIM
文本常见处理工具
文件内容查看命令
查看文本文件内容
cat
cat 可以查看文本内容 格式: cat [OPTION]… [FILE]…
常见选项
-E:显示行结束符$
-A:显示所有控制符
-n:对显示出的每一行进行编号
-b:非空行编号
-s:压缩连续的空行成一行
范例:
[root@centos8 ~]#cat -A /data/fa.txt
a  b$
c $
d^Ib^Ic$
[root@centos8 ~]#cat /data/fa.txt
a  b
c
d    b    c
[root@centos8 ~]#cat /data/fb.txt
a
b
c
[root@centos8 ~]#hexdump -C /data/fb.txt
00000000 61 0d 0a 62 0d 0a 63 0d 0a            |a..b..c..|
00000009
[root@centos8 ~]#cat -A /data/fb.txt
a^M$
b^M$
c^M$
[root@centos8 ~]#file /data/fb.txt
/data/fb.txt: ASCII text, with CRLF line terminators
nl
显示行号,相当于cat -b 选项与参数:
-b  :指定行号指定的方式,主要有两种:
      -b a :表示不论是否为空行,也同样列出行号(类似 cat -n);
      -b t :如果有空行,空的那一行不要列出行号(默认值);
-n  :列出行号表示的方法,主要有三种:
      -n ln :行号在萤幕的最左方显示;
      -n rn :行号在自己栏位的最右方显示,且不加 0 ;
      -n rz :行号在自己栏位的最右方显示,且加 0 ;
-w  :行号栏位的占用的位数。
[root@centos8 ~]#cat /data/f1.txt
a
b
c
d
e
f
g
h
[root@centos8 ~]#nl /data/f1.txt
  1 a
  2 b
  3 c
  4 d
  5 e
  6 f
  7 g
  8 h
[root@www ~]# nl -b a -n rz -w 3 /etc/issue
001     CentOS release 5.3 (Final)
002     Kernel \r on an \m
003
# 变成仅有 3 位数
tac
逆向显示文本内容
[root@centos8 ~]#cat /data/fa.txt
1
2
3
4
5
[root@centos8 ~]#tac /data/fa.txt
5
4
3
2
1
[root@centos8 ~]#tac
a
bb
ccc 按ctrl+d
ccc
bb
a
[root@centos8 ~]#seq 10 |tac
10
9
8
7
6
5
4
3
2
1
rev
将同一行的内容逆向显示
[root@centos8 ~]#cat /data/fa.txt
1 2 3 4 5
a b c
[root@centos8 ~]#tac /data/fa.txt
a b c
1 2 3 4 5
[root@centos8 ~]#rev /data/fa.txt
5 4 3 2 1
c b a
[root@centos8 ~]#rev
abcdef
fedcba
[root@centos8 ~]#echo {1..10} |rev
01 9 8 7 6 5 4 3 2 1
查看非文本文件内容
hexdump
范例:
hexdump -C -n 512 /dev/sda
00000000 eb 63 90 10 8e d0 bc 00 b0 b8 00 00 8e d8 8e c0 |.c..............|

echo {a..z} | tr -d ' '|hexdump -C
00000000 61 62 63 64 65 66 67 68 69 6a 6b 6c 6d 6e 6f 70 |abcdefghijklmnop|
00000010 71 72 73 74 75 76 77 78 79 7a 0a         |qrstuvwxyz.|
0000001b
hexdump:查看一些二进制文件的内容,比如二进制文件中包含的某些字符串。可 以将二进制文件转换为ASCII、10进制、16进制或8进制进行查看。
-b 每一字节以八进制显示,一行共16个字节,一行开始以十六进制显示偏移值;
        0000000 177 105 114 106 002 001 001 000 000 000 000 000 000 000 000 000
-c 每一字节以ASCII字符显示,其余同上;
        0000000 177  E  L  F 002 001 001  \0  \0  \0  \0  \0  \0  \0  \0  \0
-C 每一字节以16进制显示,一行共16个字节,尾部附加16个相应的ASCII字符;
          00000000  7f 45 4c 46 02 01 01 00  00 00 00 00 00 00 00 00  |.ELF............|
-n 只解释指定长度字节
        单位:默认十进制,0x或0X开头则为16进制,0开头则为8进制。默认为字节,b则为512字节,k则为1024字节,m则为1048576字节
-d 双字节十进制显示
-o 双字节八进制显示
-v 去除中间显示的“*”字符
-x 双字节十六进制显示
-e 格式化参数
od
od 即 dump files in octal and other formats
- -A:指定地址基数,od命令的输出最左侧的1列为偏移量。默认的偏移量使用8
进制,可以使用-A进行修改。
- -A参数,指定偏移量显示方式。参数有:d:十进制;o:八进制;x:十六进 制;n不显示偏移量这一列。
-t:选择输出格式。格式为:-t [acdfoux][size].
acdfoux:
a:每个ASCII码对应的名字。
b:用八进制字节表示的字符对应的ASCII码值
d:有符号数值,SIZE个字节
f:浮点数,SIZE个字节
o:八进制数,SIZE个字节
u:无符号数值,SIZE个字节
x:十六进制数,size个字节
size:
注意:这里的SIZE是一个数值或者是一个字母。字母的范围为:[CSILFD]。对
于 非f类型的,一般选择CSIL。其中

C表示sizeof(char)
S表示sizeof(short)
I表示sizeof(int)
L表示sizeof(long)

如果类型为f,sizeof可以是F或者是D,分别表示sizeof(float)或者sizeof(double).
可以使用传统的格式:分别为:
-a:等价于 -t a.表示ASCII码的名字
-b:等价于-t o1,选择单字节,并且按照3个数值位的八进制数进行解释
-c:等价于-t c,选择ASCII码字符或者是转义字符
-d:等价于-t u2:选择无符号2字节单位
-f:等价于-t fF,选择单精度浮点数
-i:等价于-t dI,选择十进制整型
-l:等价于-t dL,选择十进制长整型
-o:等价于-t o2,选择两个字节的单元并按照八进制进行解释
-s:等价于-t d2,选择两字节单元并按照十进制解释
-x:等价于-t x2,选择两个字节单元,并作十六进制解释
范例:
[root@centos8 ~]#echo {a..z} | tr -d ' '|od -t x  # 16进制显示
0000000 64636261 68676665 6c6b6a69 706f6e6d
0000020 74737271 78777675 000a7a79
0000033
[root@centos8 ~]#echo {a..z} | tr -d ' '|od -t x1  # 16进制显示中间隔开
0000000 61 62 63 64 65 66 67 68 69 6a 6b 6c 6d 6e 6f 70
0000020 71 72 73 74 75 76 77 78 79 7a 0a
0000033
[root@centos8 ~]#echo {a..z} | tr -d ' '|od -t x1z  # 16进制显示中间隔开,字母显示在右侧
0000000 61 62 63 64 65 66 67 68 69 6a 6b 6c 6d 6e 6f 70 >abcdefghijklmnop<
0000020 71 72 73 74 75 76 77 78 79 7a 0a         >qrstuvwxyz.<
0000033
其他选项
[jasper@jasper-vm ~]$ od --help
用法:od [选项]... [文件]...
 或:od [-abcdfilosx]... [文件] [[+]偏移量[.][b]]
 或:od --traditional [选项]... [文件] [[+]偏移量[.][b] [+][标签][.][b]]

以无歧义的表示方式将 <文件> 输出至标准输出,默认为八进制字节形式。
如果指定了多于一个 <文件>,则将它们按照列出的顺序连接起来作为输入。

如果没有指定 <文件>,或者 <文件> 为 "-",则从标准输入读取。

如果第一个和第二个调用格式都符合,则在最后一个操作对象以 "+" 或者数字
(当有两个操作对象时)开头的情况下,使用第二种格式。<偏移量> 作为操作
对象时,等价于 "-j 偏移量"。<标签> 是所打印的第一个字节的伪地址,随着
转储过程的进行而递增。<偏移量> 和 <标签> 如果冠以 "0x" 或 "0X" 前缀则
表示十六进制数;后缀 "." 代表八进制数,后缀 "b" 表示乘以 512。

长选项的必选参数对于短选项也是必选的。
  -A, --address-radix=基数    指定文件偏移量的输出格式;这里给出的 <基数>
                                是 [doxn] 其中之一,分别代表十进制、八进制、
                                十六进制和无基数
      --endian={big|little}   按照指定的字节序交换输入字节
  -j, --skip-bytes=字节数     处理前先跳过 <字节数> 个输入字节
  -N, --read-bytes=字节数     最多读取 <字节数> 个输入的字节
  -S 字节数, --strings[=字节数]  仅显示至少包含 <字节数>(默认为 3)个
                                   可打印字符的、以 NUL 结尾的字符串
  -t, --format=类型           选择一个或多个输出格式
  -v, --output-duplicates     不使用 "*" 字符代替被省略的行
  -w[字节数], --width[=字节数]  每一行输出 <字节数> 个字节;
                                  如未指定 <字节数>,则默认为 32
      --traditional           接受以上述第三种格式提供的参数
      --help        显示此帮助信息并退出
      --version     显示版本信息并退出


传统的格式说明符可以混合使用,不同的格式可以累加:
  -a   即 -t a, 输出字符的名称,忽略最高位
  -b   即 -t o1,输出八进制字节
  -c   即 -t c, 输出可打印字符或者使用反斜杠转义
  -d   即 -t u2,输出无符号十进制数,两个字节为一个输出单位
  -f   即 -t fF,输出浮点数
  -i   即 -t dl,输出十进制整型 (int)
  -l   即 -t dL,输出十进制长整型 (long)
  -o   即 -t o2,输出八进制数,两个字节为一个输出单位
  -s   即 -t d2,输出十进制数,两个字节为一个输出单位
  -x   即 -t x2,输出十六进制数,两个字节为一个输出单位


<类型> 是由下面一种或多种说明符组成的:
  a          字符名称,忽略最高位
  c          可打印字符或者使用反斜杠转义
  d[大小]    有符号十进制数,每个整数占 <大小> 个字节
  f[大小]    浮点数,每个浮点数占 <大小> 个字节
  o[大小]    八进制数,每个整数占 <大小> 个字节
  u[大小]    无符号十进制数,每个整数占 <大小> 个字节
  x[大小]    十六进制数,每个整数占 <大小> 个字节

<大小> 是一个数字。如果 <类型> 是 [doux] 之一,<大小> 也可以是:
C 代表 sizeof(char)、S 代表 sizeof(short)、I 代表 sizeof(int),
或 L 代表 sizeof(long)。如果 <类型> 是 f,<大小> 也可以是:
B 代表 Brain 16 位浮点、H 代表半精度浮点、F 代表 sizeof(float)、
D 代表 sizeof(double),或 L 代表 sizeof(long double)。

在任何类型后面加上 "z" 后缀,将会在每个输出行的末尾显示可打印字符。


如果 <字节数> 有 "0x" 或 "0X" 前缀,则将其视为十六进制数。
<字节数> 可以有乘数后缀:
  b    512
  KB   1000
  K    1024
  MB   1000*1000
  M    1024*1024
G、T、P、E、Z、Y、R、Q 以此类推。
也可以使用二进制前缀:KiB=K、MiB=M,以此类推。

GNU coreutils 在线帮助:<https://www.gnu.org/software/coreutils/>
请向 <http://translationproject.org/team/zh_CN.html> 报告任何翻译错误
完整文档 <https://www.gnu.org/software/coreutils/od>
或者在本地使用:info '(coreutils) od invocation'
xxd
用于使用二进制或十六进制格式显示文件内容,可以将指定文件或标准输入以十 六进制转储,也可以把十六进制转储转换成原来的二进制形式。
echo {a..z} | tr -d ' '|xxd
0000000: 6162 6364 6566 6768 696a 6b6c 6d6e 6f70 abcdefghijklmnop
0000010: 7172 7374 7576 7778 797a 0a       qrstuvwxyz.
xxd 的输出主要是三个部分:左边的地址区域,中间的 hex dump ,和右边的原始内容
- 左边显示的地址,当然也是十六进制的。默认的话一行 dump 16个字节,所以地址正好加 0x10
- 中间是经过 hex dump 后以十六进制显示的文件内容。注意到这个文件是 ascii 编码的,所以所有的字节的值都不大于 0xff
- 右边则是原文内容,如果是一些非文本文件,遇到不可打印的字符时候xxd 会输出 . 作为代替
-ps 参数:以 postscript的连续16进制转储输出,也叫做纯16进制转储。
-b参数:以2进制字符串形式输出。
-r参数:逆向转换。将16进制字符串表示转为实际的数:

-g: 几个字节组成一组
-c: 每行输出多少个字节
-i:将文件内容输出成 c的一个数组格式
-l : 输出几个字节后结束
-p -plain:以一个整块输出所有的hex, 不使用空格进行分割
-s [+][-]seek : 从第几个字符开始
-u : 输出采用大写
范例:
xxd -a -c 12 -g 1 -l 512 -s +0x200 [inputfile]
【自动跳过空白】【每行显示12字节】【一个字节一块】【显示512字节内容】【从0x200开始】【输入文件】
范例16进制字符转换
# 将字符串转换为 16 进制格式:
echo -n "string" | xxd -p

# echo -n "~" | xxd -p
7e


# 将 16 进制格式的字符串转换为字符串:
echo -n "48656c6c6f20576f726c64" | xxd -r -p

mysql> select 0x7e;
+------+
| 0x7e |
+------+
| ~    |
url编码是十六进制的形如%E6%9C%8D%E5%8A%A1%E5的字符串 编码的两种方式
echo '手机' | tr -d '\n' | xxd -plain | sed 's/\(..\)/%\1/g'
echo '手机' |tr -d '\n' |od -An -tx1|tr ' ' %

其实我们经常用的 curl 的 --data-urlencode 选项即可实现 urlencode 编码:
june@~ 23:58:38>
curl -v -L -G --data-urlencode 'wd=手机' "http://www.baidu.com/s"

解码
url="要解码的URL地址"
printf $(echo -n $url | sed 's/\\/\\\\/g;s/\(%\)\([0-9a-fA-F][0-9a-fA-F]\)/\\x\2/g')"\n"
范例:
[admin@middle-ware ~]$ echo '手机' | tr -d '\n' | xxd -plain | sed 's/\(..\)/%\1/g'
%e6%89%8b%e6%9c%ba
[admin@middle-ware ~]$ echo '手机' |tr -d '\n' |od -An -tx1|tr ' ' %
%e6%89%8b%e6%9c%ba
[admin@middle-ware ~]$ url='%e6%89%8b%e6%9c%ba'
[admin@middle-ware ~]$ printf $(echo -n $url | sed 's/\\/\\\\/g;s/\(%\)\([0-9a-fA-F][0-9a-fA-F]\)/\\x\2/g')"\n"
手机
分页查看文件内容
more
可以实现分页查看文件,可以配合管道实现输出信息的分页 格式 more [OPTIONS…] FILE…
选项: -d: 显示翻页及退出提示
less 也可以实现分页查看文件或STDIN输出
查看时有用的命令包括:
/文本搜索文本。n/N 跳到下一个 或 上一个匹配
less
less 命令是man命令使用的分页器 范例:
[root@centos8 ~]#cat /etc/init.d/functions |less
# -*-Shell-script-*-
#
# functions This file contains functions to be used by most or all
#    shell scripts in the /etc/init.d directory.
#
TEXTDOMAIN=initscripts
# Make sure umask is sane
umask 022
# Set up a default search path.
PATH="/sbin:/usr/sbin:/bin:/usr/bin"
export PATH
...省略...
显示文本前或后行内容
head
可以显示文件或标准输入的前面行
格式: head [OPTION]… [FILE]…
选项:
-c # 指定获取前#字节
-n # 指定获取前#行
-# 同上
范例:
[root@centos8 ~]#head -n 3 /etc/passwd
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin

[root@centos8 ~]#head -3 /etc/passwd
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin

[root@centos8 ~]#echo a我b | head -c4
a我[root@centos8 ~]#

[root@centos8 ~]#cat /dev/urandom | tr -dc '[:alnum:]'| head -c10
G755MlZatW[root@centos8 ~]#cat /dev/urandom | tr -dc '[:alnum:]'| head -c10
ASsax6DeBz[root@centos8 ~]#cat /dev/urandom | tr -dc '[:alnum:]'| head -c10 |tee pass.txt | passwd --stdin me
Changing password for user me.
passwd: all authentication tokens updated successfully.
[root@centos8 ~]#cat pass.txt
AGT952Essg[root@centos8 ~]#su - wang
[wang@centos8 ~]$su - me
Password:

[root@centos8 ~]#cat /data/f1.txt
1
2
3
4
5
6
7
8
9
10
[root@centos8 ~]#head -n -3 /data/f1.txt
1
2
3
4
5
6
7
[root@centos8 ~]#
tail
tail 和head 相反,查看文件或标准输入的倒数行
格式: tail [OPTION]… [FILE]…
-c # 指定获取后#字节
-n # 指定获取后#行
-# 同上
-f 跟踪显示文件fd新追加的内容,常用日志监控,相当于 --follow=descriptor,当文件删除再新建同名文件,将无法继续跟踪文件
-F 跟踪文件名,相当于--follow=name --retry,当文件删除再新建同名文件,将可以继续跟踪文件
tailf 类似 tail –f,当文件不增长时并不访问文件

注意:#号前面可使用正负号,表示该偏移从顶部还是从尾部开始计算。如+2表示从第2行到尾行,-2表示从倒数第2行到尾行。
范例:
[root@centos8 ~]#cat  /data/f1.txt
1
2
3
4
5
6
7
8
9
10
[root@centos8 ~]#tail -n 3 /data/f1.txt
8
9
10
[root@centos8 ~]#tail -n +3 /data/f1.txt
3
4
5
6
7
8
9
10
范例:
[root@centos8 ~]#tail -3 /var/log/messages
Dec 20 09:49:01 centos8 dbus-daemon[952]: [system] Successfully activated
service 'net.reactivated.Fprint'
Dec 20 09:49:01 centos8 systemd[1]: Started Fingerprint Authentication Daemon.
Dec 20 09:49:13 centos8 su[6887]: (to cici) root on pts/0
[root@centos8 ~]#tail -f /var/log/messages
。。。
  727 B/s | 1.5 kB   00:02
Dec 20 08:47:12 centos8 dnf[1465]: Metadata cache created.
Dec 20 08:47:12 centos8 systemd[1]: Started dnf makecache.

#只查看最新发生的日志
[root@centos8 ~]#tail -fn0 /var/log/messages
[root@centos8 ~]#tail -0f /var/log/messages
[root@centos8 data]#ifconfig | head -2 | tail -1
   inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255
tail拓展:
选项
--retry : 即使tail开始时就不能访问或者在tail运行后不能访问,也仍然不停地尝试打开文件. -- 只与-f合用时有用
-F : same as --follow=name --retry,即-f --retry
--max-unchanged-stats=N
-q : 不显示处理信息
-v : 显示详细的处理信息
-c<数目> : 显示的字节数
-n<行数> : 显示行数  ***
--pid=PID : 与-f合用,表示在进程ID,PID死掉之后结束.
-q, --quiet, --silent : 从不输出给出文件名的首部
-s, --sleep-interval=S : 与-f合用,表示在每次反复的间隔休眠S秒
tail 断点续传
[root@nginx01 ~]# tail -n +$(tail -n1 /root/n) -F /root/ip.txt 2>&1 | awk 'ARGIND==1{i=$0;next}{i++;if($0~/^tail/){i=0};print $0;print i > "/root/n";fflush("")}' /root/n -
如,flume日志收集中设置断点收集
a1.sources.r1.type = exec
a1.sources.r1.shell = /bin/bash -c
a1.sources.r1.command = tail -n +$(tail -n1 /home/hadoop/flume_read/m) -F /home/hadoop/student.txt | awk 'ARGIND==1{i=$0;next}{i++;if($0~/^tail/){i=0};print
$0;print i >> "/home/hadoop/flume_read/m";fflush("")}' /home/hadoop/flume_read/m -

解释:
ARGC        The number of command line arguments (does not include
                   options to gawk, or the program source).   命令行参数的个数
ARGIND      The index in ARGV of the current file being processed. 命令行中文件序号
ARGV        Array of command line arguments. The array is indexed
                   from 0 to ARGC - 1. Dynamically changing the contents
                   of ARGV can control the files used for data. 命令行参数数组
大体类似于C语言 int main(int argc,char *argv[])
我要比较a和b两个文件;
a b
1 1
qw 2
qq d
123 cd
我怎么才能列出b文件中完全不包含a文件的行??
解答: awk 'ARGIND==1 {a[$0]} ARGIND>1&&!($0 in a) {print $0}' a b
或者: awk 'NR==FNR {a[$0]} NR>FNR&&!($0 in a) {print $0}' a b
代码解释:
ARGIND==1{a[$0]}
#ARGIND==1 判断是否正在处理第一个文件,本例为文件a
# {a[$0]} 初始化(或叫做定义)a[$0]
ARGIND>1&&!($0 in a){print $0}
#ARGIND>1 判断是否在处理第二个或第n个文件,本例只有一个文件b
#并且判断a[$0]是否未定义,然后打印$0


fflush函数用以刷新输出缓冲区,如果没有参数,就刷新标准输出的缓冲区,如果以空字符串为参数,如fflush(""),则刷新所有文件和管道的输出缓冲区。
这里的fflush是向n文件中写入
参考:flume中的断点续传 http://blog.csdn.net/smallboy2011/article/details/73163664

按列抽取文本cut
cut 命令可以提取文本文件或STDIN数据的指定列
格式 cut [OPTION]… [FILE]…
选项
-d DELIMITER: 指明分隔符,默认tab
-f FILEDS:
   #: 第#个字段,例如:3
   #,#[,#]:离散的多个字段,例如:1,3,6
   #-#:连续的多个字段, 例如:1-6
   混合使用:1-3,7
-c 按字符切割
--output-delimiter=STRING指定输出分隔符
范例:
[root@centos8 ~]#cut -d: -f1,3-4,7 /etc/passwd
[root@centos8 ~]#ifconfig |head -n2 |tail -n1|cut -d" " -f10
10.0.0.8
[root@centos8 ~]#ifconfig |head -n2 |tail -n1|tr -s " " |cut -d " " -f3
10.0.0.8
[root@centos8 ~]#df | tr -s ' '|cut -d' ' -f5 |tr -dc "[0-9\n]"
0
0
1
0
5
1
15
1
[root@centos8 ~]#df | tr -s ' ' % |cut -d% -f5 |tr -d '[:alpha:]'
0
0
1
0
5
1
15
1
[root@centos8 ~]#df | cut -c44-46 |tr -d '[:alpha:]'
 0
 0
 1
 0
 5
 1
15
 1
[root@centos8 ~]#cut -d: -f1,3,7 --output-delimiter="---" /etc/passwd
root---0---/bin/bash
bin---1---/sbin/nologin
daemon---2---/sbin/nologin

cat /etc/passwd | cut -d: -f7
cut -c2-5 /usr/share/dict/words

[root@centos8 ~]#df|tr -s ' ' |cut -d' ' -f5 |tr -d %
[root@centos8 ~]#df|tr -s ' ' '%'|cut -d% -f5
Use
0
0
2
0
3
1
15
0
100
字符转换命令: tr, col, join, paste
转换和删除字符tr
#该命令会把/etc/issue中的小写字符都转换成大写字符
tr 'a-z' 'A-Z'< /etc/issue

#删除fstab文件中的所有abc中任意字符
tr –d abc < /etc/fstab

# 取指定字符,只显示20个
tr -dc '#@%a-z0-9' < /dev/urandom |head -c 20
IO重定向细讲
col
格式
col [-xb]
选项与参数:
-x  :将 tab 键转换成对等的空格键
-b  :在文字内有反斜杠 (/) 时,仅保留反斜杠最后接的那个字符
范例:利用 cat -A 显示出所有特殊按键,最后以 col 将 [tab] 转成空白
[root@www ~]# cat -A /etc/man.config  # 此时会看到很多 ^I 的符号,那就是 tab
[root@www ~]# cat /etc/man.config | col -x | cat -A | more
范例:将 col 的 man page 转存成为 /root/col.man 的纯文本档
[root@www ~]# man col > /root/col.man
[root@www ~]# vi /root/col.man
COL(1)          BSD General Commands Manual               COL(1)

N^HNA^HAM^HME^HE
     c^Hco^Hol^Hl - filter reverse line feeds from input

S^HSY^HYN^HNO^HOP^HPS^HSI^HIS^HS
     c^Hco^Hol^Hl [-^H-b^Hbf^Hfp^Hpx^Hx] [-^H-l^Hl _^Hn_^Hu_^Hm]
# 由于 man page 内有些特殊按钮会用来作为类似特殊按键与颜色显示,
# 所以这个文件内就会出现如上所示的一堆怪异字符(有 ^ 的)

[root@www ~]# man col | col -b > /root/col.man
多文件数据合并join
两个文件之间的数据 格式
join [-ti12] file1 file2
选项与参数:
-t  :join 默认以空格符分隔数据,并且比对『第一个字段』的数据,如果两个文件相同,则将两笔数据联成一行,且第一个字段放在第一个!
-i  :忽略大小写的差异;
-1  :这个是数字的 1 ,代表『第一个文件要用那个字段来分析』的意思;
-2  :代表『第二个文件要用那个字段来分析』的意思。
范例:用 root 的身份,将 /etc/passwd 与 /etc/shadow 相关数据整合成一栏
[root@www ~]# head -n 3 /etc/passwd /etc/shadow
==> /etc/passwd <==
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin

==> /etc/shadow <==
root:$1$/3AQpE5e$y9A/D0bh6rElAs:14120:0:99999:7:::
bin:*:14126:0:99999:7:::
daemon:*:14126:0:99999:7:::
# 由输出的数据可以发现这两个文件的最左边字段都是账号!且以 : 分隔

[root@www ~]# join -t ':' /etc/passwd /etc/shadow
root:x:0:0:root:/root:/bin/bash:$1$/3AQpE5e$y9A/D0bh6rElAs:14120:0:99999:7:::
bin:x:1:1:bin:/bin:/sbin/nologin:*:14126:0:99999:7:::
daemon:x:2:2:daemon:/sbin:/sbin/nologin:*:14126:0:99999:7:::
# 透过上面这个动作,我们可以将两个文件第一字段相同者整合成一行!
# 第二个文件的相同字段并不会显示(因为已经在第一行了!)
范例:将/etc/passwd 第四个字段 GID ,那个 GID 记录在/etc/group 当中的第三个字段,将两个文件整合
[root@www ~]# head -n 3 /etc/passwd /etc/group
==> /etc/passwd <==
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin

==> /etc/group <==
root:x:0:root
bin:x:1:root,bin,daemon
daemon:x:2:root,bin,daemon
# 从上面可以看到,确实有相同的部分喔!赶紧来整合一下!

[root@www ~]# join -t ':' -1 4 /etc/passwd -2 3 /etc/group
0:root:x:0:root:/root:/bin/bash:root:x:root
1:bin:x:1:bin:/bin:/sbin/nologin:bin:x:root,bin,daemon
2:daemon:x:2:daemon:/sbin:/sbin/nologin:daemon:x:root,bin,daemon
# 同样的,相同的字段部分被移动到最前面了!所以第二个文件的内容就没再显示。
此外,需要特别注意的是,在使用 join之前,你所需要处理的文件应该要事先 经过排序 (sort) 处理!否则有些比对的项目会被略过呢!特别注意了!
多个文件合并paste
paste 合并多个文件同行号的列到一行
这个 paste 就要比 join简单多了!相对于 join 必须要比对两个文件的数据相 关性, paste就直接『将两行贴在一起,且中间以 [tab] 键隔开』而已
格式
paste [OPTION]... [FILE]...
选项
-d 分隔符:指定分隔符,默认用TAB
-s : 所有行合成一行显示

paste file1 file2 合并两个文件或两栏的内容
paste -d '+' file1 file2 合并两个文件或两栏的内容,中间用"+"区分
范例:
如果分隔符写多个,则会分先后顺序依次放出分隔符
[root@ct8-ts1 master]# paste -s  num2.txt
1    1    2    2    3    3
[root@ct8-ts1 master]# paste -s -d '=\n' num2.txt
1=1
2=2
3=3
范例:
[root@centos8 ~]#cat alpha.log
a
b
c
d
e
f
g
h
[root@centos8 ~]#cat seq.log
1
2
3
4
5
[root@centos8 ~]#cat alpha.log seq.log
a
b
c
d
e
f
g
h
1
2
3
4
5
[root@centos8 ~]#paste alpha.log seq.log
a 1
b 2
c 3
d 4
e 5
f
g
h

[root@centos8 ~]#paste -d":" alpha.log seq.log #两栏的内容,中间用":"区分
a:1
b:2
c:3
d:4
e:5
f:
g:
h:
[root@centos8 ~]#paste -s seq.log
1 2 3 4 5
[root@centos8 ~]#paste -s alpha.log
a b c d e f g h
[root@centos8 ~]#paste -s alpha.log seq.log
a b c d e f g h
1 2 3 4 5

[root@centos8 ~]#cat title.txt
ceo
coo
cto
[root@centos8 ~]#cat emp.txt
me
zhang
wang
xu
[root@centos8 ~]#paste title.txt emp.txt
ceo me
coo zhang
cto wang
    xu
[root@centos8 ~]#paste -s title.txt emp.txt
ceo coo cto
me zhang wang xu

sed -ri '$r '<( paste -d '' <(seq -f 'IP.%g = ' 2 $[${#MasterArray[@]}+1]) <(xargs -n1<<<${MasterArray[@]} | sort) ) ~/k8s-manual-files/04-tls/openssl.cnf
文本流格式化为多列输出column
它特别适用于将文本文件的内容以整齐的列格式显示,使得数据更加易于阅读
常用选项
-t:输出表格格式,自动对齐列。
-c:连续输出,不跳到下一页。
-s:指定分隔符,默认是制表符(tab),可以是任何字符。
-x:使用空格作为分隔符。
-p:使用行首和行尾的分隔符。
-o : 列与列之间的分隔符
范例:输出一个类似表格的输出格式
cat<<EOF> a.log
name age city
Alice 30 New York
Bob 25 Los Angeles
Carol 35 Chicago
EOF

bin]# column -t -o '| ' a.log
name | age| city   |
Alice| 30 | New    | York
Bob  | 25 | Los    | Angeles
Carol| 35 | Chicago|
vmstat 1 4 |column -t
#展示内容
procs  -----------memory----------  ---swap--  -----io----  -system--  ------cpu-----
r      b                            swpd       free         buff       cache           si  so  bi   bo   in     cs     us  sy  id  wa  st
2      0                            0          12184500     33532      1404544         0   0   2    36   0      0      6   3   92  0   0
2      0                            0          12162792     33544      1405456         0   0   140  440  30221  41481  33  5   62  0   0
2      0                            0          12162060     33544      1405880         0   0   32   420  28039  38302  32  5   64  0   0
3      0                            0          12137168     33544      1406340         0   0   96   0    31062  38257  30  5   65  0   0
转换文件字符集编码iconv
iconv [选项…] [文件…]
选项可:
输入/输出格式规范:
-f, --from-code=名称 原始文本编码
-t, --to-code=名称 输出编码

信息:
-l, --list 列举所有已知的字符集

输出控制:
-c 从输出中忽略无效的字符
-o, --output=FILE 输出文件
-s, --silent 关闭警告
--verbose 打印进度信息
范例:转换文件字符集编码
#显示支持字符集编码列表
[root@centos8 ~]#iconv -l

#windows10上文本默认的编码ANSI(GB2312)
[root@centos8 data]#file windows.txt
windows.txt: ISO-8859 text, with no line terminators

[root@centos8 data]#echo $LANG
en_US.UTF-8

#默认在linux无法正常显示文本内容
[root@centos8 data]#cat windows11.txt
▒▒▒▒▒▒[root@centos8 data]#

#将windows10上文本默认的编码ANSI(GB2312)转换成UTF-8
[root@centos8 data]#iconv -f gb2312 windows.txt -o windows1.txt
[root@centos8 data]#cat windows1.txt
abc[root@centos8 data]#ll windows1.txt
-rw-r--r-- 1 root root 12 Mar 23 10:13 windows1.txt
[root@centos8 data]#file windows1.txt
windows1.txt: UTF-8 Unicode text, with no line terminators

#将UTF-8转换成windows10上文本默认的编码ANSI(GB2312)
[root@centos8 data]#iconv -f utf8 -t gb2312 windows1.txt -o windows11.txt
[root@centos8 data]#file windows11.txt
windows11.txt: ISO-8859 text, with no line terminators
范例:
#将windows10上文本默认的编码ANSI(GB2312)转换成UTF-8
[15:34:50 root@centos8 ~]#iconv -f gb2312 win.txt -o win2.txt
[15:34:50 root@centos8 ~]#file linux.txt
linux.txt: ASCII text
[15:34:31 root@centos8 ~]#file windows.txt
windows.txt: ASCII text, with CRLF line terminators
#将windows的文本格式转换成Linux的文本格式
[15:35:26 root@centos8 ~]#dos2unix windows.txt
dos2unix: converting file windows.txt to Unix format...
[15:36:00 root@centos8 ~]#file windows.txt
windows.txt: ASCII text
分割命令: split
常用选项
-a : 指定后缀长度
-b : 每个文件多少字节
-d : 使用数字后缀而不是字母
-l : 指定每个文件的行数
--verbose
范例:
split -l 138000 -d archive.txt tmp/archive- --verbose
分析文本的工具
文本数据统计:wc 整理文本:sort 比较文件:diff和patch
收集文本统计数据wc
wc 命令可用于统计文件的行总数、单词总数、字节总数和字符总数
可以对文件或STDIN中的数据统计
常用选项
-l 只计数行数
-w 只计数单词总数
-c 只计数字节总数
-m 只计数字符总数
-L 显示文件中最长行的长度
范例:
wc story.txt
39   237   1901 story.txt
行数  单词数  字节数

[root@centos8 ~]#ll title.txt
-rw-r--r-- 1 root root 30 Dec 20 11:05 title.txt
[root@centos8 ~]#ll title1.txt
-rw-r--r-- 1 root root 28 Dec 20 11:06 title1.txt
[root@centos8 ~]#cat title.txt
ceo cici
coo zhang
cto 老王
[root@centos8 ~]#cat title1.txt
ceo zzzz
coo zhang
cto wang
[root@centos8 ~]#wc title.txt
3  6 30 title.txt
[root@centos8 ~]#wc title1.txt
3  6 28 title1.txt

[root@centos8 ~]#wc -l title.txt
3 title.txt
[root@centos8 ~]#cat title.txt | wc -l
3

[root@centos8 ~]#df | tail -n $(echo `df | wc -l`-1|bc)
devtmpfs      910220    0   910220  0% /dev
tmpfs       924728    0   924728  0% /dev/shm
tmpfs       924728   9224   915504  1% /run
tmpfs       924728    0   924728  0% /sys/fs/cgroup
/dev/sda2    104806400 4836160  99970240  5% /
/dev/sda3    52403200  398580  52004620  1% /data
/dev/sda1     999320  131764   798744  15% /boot
tmpfs       184944    4   184940  1% /run/user/0
文本排序sort
官方文档:https://www.gnu.org/software/coreutils/manual/html_node/sort-invocation.html#sort-invocation
把整理过的文本显示在STDOUT,不改变原始文件 格式: sort [options] file(s)
常用选项
-r 执行反方向(由上至下)整理
-R 随机排序
-n 执行按数字大小整理
-f 选项忽略(fold)字符串中的字符大小写
-c 测试文件是否已经分类。
-m 合并两个分类文件。 -m 合并两个分类文件。
-u 选项(独特,unique),合并重复项,即去重
-o 存储sort结果的输出文件名。

-b :忽略最前面的空格符部分;
-t c 选项使用c做为字段界定符
-k pos1[,pos2] #指定一个由行中的部分组成的排序字段 从 pos1 和 pos2(或行尾,如果省略 pos2), 包含 。
pos 指定字段编号(从 1 开始),字段之间由空白字符分隔,默认情况下,
这些空白字符包含在每个字段的开始处。要调整空白字符的处理方式,请参阅 -b 选项和 -t 选项

每个 pos 的形式为‘ f[.c][opts] ’
其中 f 是使用字段的编号,而 c 是计数 从字段开头获取第一个字符。字段和
字符 位置从1开始编号;字符位置从0开始 pos2 表示字段的最后一个字符。如
果从 pos1 中省略了 ‘ .c ’,则默认为 1(字段的开始处);如果从 pos2
中省略了,则默认为 0(字段的末尾)。 opts 是排序选项,允许根据不同的规
则对单个键进行排序;详细信息请见下文。键可以跨越多个字段。

示例:要在第二个字段上排序,请使用--key=2,2 ( -k 2,2 )。有关键和更多
示例的说明,请参阅下文。还可以查看--debug 选项,以帮助确定正在使用的行
部分。
其它选项
-M :以月份的名字来排序,例如 JAN, DEC 等等的排序方法;
-T DIRECTORY 使用DIRECTORY作为临时文件,而不是$TMPDIR或者/tmp
范例:
[root@centos8 data]#cut -d: -f1,3 /etc/passwd|sort -t: -k2 -nr |head -n3
nobody:65534
xiaoming:1002
me:1001
#统计日志访问量
[root@centos8 data]#cut -d" " -f1 /var/log/nginx/access_log |sort -u|wc -l
201
注意:
- ASCII码表中的升序排序
- 默认不是比较数字大小
- 逐个字符的ASCII码大小比较排序
如:合并
sort -m -k 1 -T /ops/swap -o ${local_path}/${log} ${local_path}/${log}_*
范例:统计分区利用率
[root@centos8 ~]#df
Filesystem   1K-blocks  Used Available Use% Mounted on
devtmpfs     391676    0  391676  0% /dev
tmpfs       408092    0  408092  0% /dev/shm
tmpfs       408092  5816  402276  2% /run
tmpfs       408092    0  408092  0% /sys/fs/cgroup
/dev/sda2   104806400 2259416 102546984  3% /
/dev/sda3    52403200 398608 52004592  1% /data
/dev/sda1     999320 130848  799660 15% /boot
tmpfs       81616    0   81616  0% /run/user/0
/dev/sr0     7377866 7377866     0 100% /misc/cd

#查看分区利用率最高值
[root@centos8 ~]#df| tr -s ' ' '%'|cut -d% -f5|sort -nr|head -1
100
[root@centos8 ~]#df | tr -s " " %|cut -d% -f5|tr -d '[:alpha:]' | sort
0
0
0
1
1
1
15
5
[root@centos8 ~]#df | tr -s " " %|cut -d% -f5|tr -d '[:alpha:]' | sort -n
0
0
0
1
1
1
5
15
[root@centos8 ~]#df | tr -s " " %|cut -d% -f5|tr -d '[:alpha:]' | sort -n |tail -n1
15
[root@centos8 ~]#df | tr -s " " %|cut -d% -f5|tr -d '[:alpha:]' | sort -nr
15
5
1
1
1
0
0
0
[root@centos8 ~]#df | tr -s " " %|cut -d% -f5|tr -d '[:alpha:]' | sort -nr|head -n1
15
sort file1 file2 排序两个文件的内容
sort file1 file2 | uniq 取出两个文件的并集(重复的行只保留一份)
sort file1 file2 | uniq -u 删除交集,留下其他的行
sort file1 file2 | uniq -d 取出两个文件的交集(只留下同时存在于两个文件中的文件)
详细解释
下面是文件video的清单,包含了上个季度家电商场的租金情况。各域为:
(1)名称,(2)供货区代码,(3)本季度租金,(4)本年租金。
域分隔符为冒号,为此对此例需使用‘-t’选项。文件如下:
cat <<\EOF> video
Boys in Company C       :HK     :192    :2192
Alien                   :HK     :119    :1982
The Hill                :KL     :63     :2972
Aliens                  :HK     :532    :4892
Star Wars               :HK     :301    :4102
A Few Good Men :KL      :445    :5851
Toy Story               :HK     :239    :3972
EOF
sort字段的参照方式:
#-t 默认空格制表符为字段分隔
字段1                   字段2   字段3    字段3
Boys in Company C       :HK     :192    :2192
Alien                   :HK     :119    :1982
The Hill                :KL     :63     :2972
Aliens                  :HK     :532    :4892
Star Wars               :HK     :301    :4102
A Few Good Men          :KL     :445    :5851
Toy Story               :HK     :239    :3972
文件是否已分类
- 怎样分辨文件是否已分类?如果只有30行,看看就知道了,但如果是400行呢,使用sort -c查看sort文件是否按某种顺序分类。
- 没有任何错误提示,返回提示符表明已分类。然而如果测试成功,返回一个信息行会更好。
[root@grafana .jasper]# sort -c video
sort: video:2: disorder: Alien                   :HK     :119    :1982

#结果显示未分类,现在将video分类,并存为2.video
[root@grafana .jasper]# sort -t: video >2.video
[root@grafana .jasper]# sort -c 2.video
[root@grafana .jasper]#
在不符合 POSIX 1003.1-2001 标准的系统上, sort 支持传统的以零为起始的
语法 +pos1 [-pos2] 来指定排序键。如果 y 存在或不存在,则传统命令
sort +a.x -b.y 等同于 sort -k a+1.x+1,b 。 否则它等同于 sort -k a+1.x+1,b+1.y
sort -t: -k[field_start[type][,field_end[type]]] video

sort -t: -k2,2 -k1,1 video
字段分隔符: -t: 表示用冒号 : 分隔字段。
主排序键: -k2,2 表示仅以第 2 个字段作为主键(从第 2 个字段开始,到第 2 个字段结束)。
次排序键: -k1,1 表示仅以第 1 个字段作为次键。
排序规则: 默认按字典序(字符串比较)排序。
[root@grafana .jasper]# sort -t: -k2,2 -k1,1 video
Alien                   :HK     :119    :1982
Aliens                  :HK     :532    :4892
Boys in Company C       :HK     :192    :2192
Star Wars               :HK     :301    :4102
Toy Story               :HK     :239    :3972
The Hill                :KL     :63     :2972
A Few Good Men :KL      :445    :5851

sort -t: -k2 -k1,1 video
主排序键: -k2 未指定结束字段,默认从第 2 个字段开始到行尾。
次排序键: -k1,1 同上。
排序规则: 默认字典序。
[root@grafana .jasper]# sort -t: -k2 -k1,1 video
Alien                   :HK     :119    :1982
Boys in Company C       :HK     :192    :2192
Toy Story               :HK     :239    :3972
Star Wars               :HK     :301    :4102
Aliens                  :HK     :532    :4892
A Few Good Men :KL      :445    :5851
The Hill                :KL     :63     :2972


sort -t: -k2,2n -k3.3,3.4 video
主排序键: -k2,2n 表示以第 2 个字段作为主键,并按数值(n)排序。
次排序键: -k3.3,3.4 表示以第 3 个字段的第 3 到第 4 个字符作为次键。
排序规则:
主键按数值大小排序。
次键按字符串字典序排序,但仅截取第 3 个字段的第 3-4 个字符。
[root@grafana .jasper]# sort -t: -k2,2n -k3.3,3.4 video
The Hill                :KL     :63     :2972
Star Wars               :HK     :301    :4102
Aliens                  :HK     :532    :4892
Boys in Company C       :HK     :192    :2192
A Few Good Men :KL      :445    :5851
Alien                   :HK     :119    :1982
Toy Story               :HK     :239    :3972
面试题:有两个文件,a.txt与b.txt,合并两个文件,并输出时确保每个数字也 唯一
#a.txt中的每一个数字在本文件唯一
200
100
34556
23
...

#b.txt中的每一个数字在本文件唯一
123
43
200
3321
...

#就是将两个文件合并后重复的行去除,不保留
100
345563
123
43
3321
...
去重uniq
uniq命令从输入中删除前后相接的重复的行
格式: uniq [OPTION]… [FILE]…
常见选项:
-c: 显示每行重复出现的次数
-d: 仅显示重复过的行
-u: 仅显示不曾重复的行
uniq常和sort 命令一起配合使用:
范例:
sort userlist.txt | uniq -c
范例:统计日志访问量最多的请求
[root@centos8 data]#cut -d" " -f1 access_log |sort |uniq -c|sort -nr |head -3
 4870 172.20.116.228
 3429 172.20.116.208
 2834 172.20.0.222
[root@centos8 data]#lastb -f btmp-34 | tr -s ' ' |cut -d ' ' -f3|sort |uniq -c
|sort -nr | head -3
 86294 58.218.92.37
 43148 58.218.92.26
 18036 112.85.42.201
范例:并发连接最多的远程主机IP
[root@centos8 ~]#ss -nt|tail -n+2 |tr -s ' ' : |cut -d: -f6|sort|uniq -c|sort -nr |head -n2
  7 10.0.0.1
  2 10.0.0.7
范例:取两个文件的相同和不同的行
[root@centos8 data]#cat test1.txt
a
b
1
c
[root@centos8 data]#cat test2.txt
b
e
f
c
1
2
#取文件的共同行
[root@centos8 data]#cat test1.txt test2.txt | sort |uniq -d
1
b
c
#取文件的不同行
[root@centos8 data]#cat test1.txt test2.txt | sort |uniq -u
2
a
e
f
统计代码行数cloc
Cloc (opens new window)是一款使用 Perl语言开发的开源代码统计工具,支持 多平台使用、多语言识别,能够计算指定目标文件或文件夹中的文件数(files)、 空白行数(blank)、注释行数(comment)和代码行数(code)。
# Mac 系统安装
$ brew install cloc

# Vue 工程代码统计
$ cloc ./ --exclude-dir=node_modules
常用命令:
- cloc ./ 统计当前文件夹代码量
- cloc ./ –exclude-dir=目录名 统计排除当前目录下的某个文件夹的代码量,多个文件使用,分隔
- cloc -by-file 文件后缀名 统计特定文件的代码量
比较文件
diff
diff是Unix系统的一个很重要的工具程序。它用来比较两个文本文件的差异,是 代码版本管理的核心工具之一。其用法非常简单:
diff <变动前的文件> <变动后的文件>
由于历史原因,diff有三种格式:
- 正常格式(normal diff)
- 上下文格式(context diff)=-c=
- 合并格式(unified diff)=-u=
1、正常格式的diff
# diff file1 file2

[root@centos8 ~]#cat f1.txt # 变动前的文件
me
zhang
wang
xu
[root@centos8 ~]#cat f2.txt # 变动后的文件
mu
zir
wang
xu
shi

[root@centos8 ~]#diff f1.txt f2.txt
1,2c1,2
< me
< zhang
---
> me
> zir
4a5
> shi
显示结果中: 第一行: 一个提示,用来说明变动位置。
它分成三个部分:
- 前面的数字:表示file1的第n行有变化;
- 中间的变动的模式: c: (change)内容改变,a: (addition)"增加", d: (deletion)删除;
缺点:显示结果太简单
2、上下文格式的diff
上个世纪80年代初,加州大学伯克利分校推出BSD版本的Unix时,觉得diff的显 示结果太简单,最好加入上下文,便于了解发生的变动。因此,推出了上下文格 式的diff。它的使用方法是加入-c选项(即context)。
# diff -c f1 f2

[root@centos8 ~]# diff -c f1.txt  f2.txt
** f1.txt  2021-04-21 17:11:13.651012923 +0800
--- f2.txt  2021-04-21 17:11:22.927070433 +0800
***************
** 1,4 ****
! me
! zhang
  wang
  xu
--- 1,5 ----
! mu
! zir
  wang
  xu
+ shi
结果分成四个部分。
- 第一部分:两行,显示两个文件的基本情况:文件名和时间信息,“***"表示 变动前的文件,"—“表示变动后的文件。
- 第二部分:15个星号,将文件的基本情况与变动内容分割开。
- 第三部分:显示变动前的文件,即file1。另外,文件内容的每一行最前面, 还有一个标记位。如果为空,表示该行无变化;如果是感叹号(!),表示该 行有改动;如果是减号(-),表示该行被删除;如果是加号(+),表示该行 为新增。
- 第四部分:显示变动后的文件,即file2。
缺点:将显示大量重复的内容,很浪费空间
3、合并格式的diff
如果两个文件相似度很高,那么上下文格式的diff,将显示大量重复的内容,很浪费空间。1990年,GNU diff率先推出了”合并格式”的diff,将f1和f2的上下文合并在一起显示。 它的使用方法是加入u参数(代表unified)。
[root@centos8 ~]#diff -u f1.txt f2.txt
--- f1.txt 2019-12-13 21:31:30.892775671 +0800
+++ f2.txt 2019-12-13 22:00:14.373677728 +0800
@@ -1,4 +1,5 @@
-me
-zhang
+mu
+zir
wang
xu
+shi
其结果
- 第一部分:文件的基本信息。"—"表示变动前的文件,"
+"表示变动后的文件。 - 第二部分:变动的位置用两个@作为起首和结束。
- 第三部分是变动的具体内容。除了有变动的那些行以外,也是上下文各显示3 行。它将两个文件的上下文,合并显示在一起,所以叫做”合并格式”。每一 行最前面的标志位,空表示无变动,减号表示第一个文件删除的行,加号表示 第二个文件新增的行。
# 打补丁
[root@centos8 ~]#diff -u f1.txt f2.txt > f.patch
[root@centos8 ~]#rm -f f2.txt
[root@centos8 ~]#patch -b f1.txt f.patch
patching file f1.txt
[root@centos8 ~]#cat f1.txt
mu
zir
wang
xu
shi
[root@centos8 ~]#cat f1.txt.orig
me
zhang
wang
xu
注明第5行有区别(改变)
复制对文件改变patch diff
命令的输出被保存在一种叫做“补丁”的文件中
使用 -u选项来输出“统一的(unified)”diff格式文件,最适用于补丁文件
范例:进程替换比较两个 curl 响应
diff -aNur <(curl -s httpbin.org/get) <(curl -s httpbin.org/get)
--- /dev/fd/63  2022-10-18 16:02:18.633005560 +0800
+++ /dev/fd/62  2022-10-18 16:02:18.633005560 +0800
@@ -4,7 +4,7 @@
     "Accept": "*/*",
     "Host": "httpbin.org",
     "User-Agent": "curl/7.68.0",
-    "X-Amzn-Trace-Id": "Root=1-634e5d8b-1eb31b42468a62f11ca13683"
+    "X-Amzn-Trace-Id": "Root=1-634e5d8b-3d27e89e310ea9fb56e8c0a8"
   },
patch
patch 复制在其它文件中进行的改变(要谨慎使用)
适用 -b 选项来自动备份改变了的文件
常用选项:
- -i : 打补丁
- -R : 还原补丁
范例:
diff -u foo.conf foo2.conf > foo.patch
patch -b foo.conf foo.patch
二进制文件的不同 cmp
范例:查看二进制文件的不同
[root@centos8 data]#ll /usr/bin/dir /usr/bin/ls
-rwxr-xr-x. 1 root root 166448 May 12  2019 /usr/bin/dir
-rwxr-xr-x. 1 root root 166448 May 12  2019 /usr/bin/ls
[root@centos8 data]#ll /usr/bin/dir /usr/bin/ls -i
201839444 -rwxr-xr-x. 1 root root 166448 May 12  2019 /usr/bin/dir
201839465 -rwxr-xr-x. 1 root root 166448 May 12  2019 /usr/bin/ls
[root@centos8 data]#diff /usr/bin/dir /usr/bin/ls
Binary files /usr/bin/dir and /usr/bin/ls differ

[root@centos8 ~]#cmp /bin/dir /bin/ls
/bin/dir /bin/ls differ: byte 737, line 2
[root@centos8 ~]#hexdump -s 730 -Cn 7 /bin/dir
000002da  00 00 47 4e 55 00 b0               |..GNU..|
000002e1
[root@centos8 ~]#hexdump -s 730 -Cn 7 /bin/ls
000002da  00 00 47 4e 55 00 93               |..GNU..|
000002e1
comm比较文件取集合
comm命令用于比较两个已排序的文件,并输出它们的交集、差集和并集。
comm [option]... file1 file2
其中,option表示选项,file1和file2表示要比较的两个文件。常用选项包括:
-1:只输出file1中有而file2中没有的行。
-2:只输出file2中有而file1中没有的行。
-3:只输出file1和file2中都存在的行。
-i:在比较时忽略大小写。
-u:将所有不同的行都输出。
comm -1 file1 file2 比较两个文件的内容只删除 'file1' 所包含的内容
comm -2 file1 file2 比较两个文件的内容只删除 'file2' 所包含的内容
comm -3 file1 file2 比较两个文件的内容只删除两个文件共有的部分
json文件分析jq
jq使用 jq是一个命令行处理json的工具。
现在大部分交互的数据格式都是以json的形式,不管是写一些监控脚本或者平时 使用,都是一个比较方便的工具,本文总结下一些基本用法,包括格式化数据, 过滤,排序等常用功能。
1.安装使用
yum install -y epel-release
yum install -y jq
2.格式化输出
默认pretty输出,如果需要压缩,使用-c选项
cat >me.json <<\EOF
{"username":"henry","age":25,"email":"[email protected]","blog":"http://thoreauz.com","hobby":["music","writing","photography"],"education":{"school":"MIT","degree":"Master"}}
EOF

[root@agent01 learn]# cat me.json |jq .
{
  "username": "henry",
  "age": 25,
  "email": "[email protected]",
  "blog": "http://thoreauz.com",
  "hobby": [
    "music",
    "writing",
    "photography"
  ],
  "education": {
    "school": "MIT",
    "degree": "Master"
  }
}
3.过滤
使用.foo,选择对象的foo字段,.foo?和前者一样,但出错时不输出出错信息。
cat jqtest.json |jq .email

过滤字段
$ echo '{"name":"wxnacy", "id": 1, "age": 23}' | jq '{"name", "id"}'
{
  "name": "wxnacy",
  "id": 1
}
3.1 使用逗号获取多个值
[root@agent01 learn]# jq '.email, .age' me.json
"[email protected]"
25
3.2 数组
[root@agent01 learn]# cat me.json | jq .hobby[1]
"writing"
3.3 数据分片
[root@agent01 learn]# cat me.json | jq .hobby[:2]
[
  "music",
  "writing"
]
3.4 数组遍历
[root@agent01 learn]# echo "{\"a\": 1, \"b\": 2}"|jq '.[]'
1
2

[root@agent01 learn]# echo '[{"name":"JSON", "good":true}, {"name":"XML", "good":false}]' | jq '.[] | .name'
"JSON"
"XML"
前面的示例严格说是获取特定字段,如果想做更细致的过滤可以使用select函数。
[root@agent01 learn]# cat me.json | jq -r '.education | select(.school == "MIT")'
{
  "school": "MIT",
  "degree": "Master"
}
4.构造新对象
[root@agent01 learn]# cat me.json | jq '.|{"name": .username, "like": .hobby[1]}'
{
  "name": "henry",
  "like": "writing"
}
5.高级用法 5.1 map函数
[root@agent01 learn]# echo "[1,2,3,4]"| jq  'map(select(.>2))' -c
[3,4]
5.2 Reduce函数
[root@agent01 learn]# echo '[0,1,2,3,4,5,6,7,8,9]' | jq 'reduce .[] as $n ([]; if ($n%2==0) then . else . + [$n] end)' -c
[1,3,5,7,9]
从示例中看到了很多用法,reduce遍历,定义变量$n,可以使用 if-elif-else-end,添加数据+[]。
总之,他就像awk一样是个小型的编程语言,可以自定义函数,具有I/O和Stream, 几乎能实现自己想要的任何json处理。
参考文档:
范例:k8s pod统计
# 列出属于特定RC的Pod名称
#jq命令对于复杂的json路径转换很有用, 更多详情https://stedolan.github.io/jq/
sel=${$(kubectl get rc my-rc --output=json | jq -j '.spec.selector | to_entries | .[] | "\(.key)=\(.value),"')%?}
echo $(kubectl get pods --selector=$sel --output=jsonpath={.items..metadata.name})

# 显示所有pod(或任何其他支持标签的Kubernetes对象)的标签
# Also uses "jq"
for item in $( kubectl get pod --output=name); do printf "Labels for %s\n" "$item" | grep --color -E '[^/]+$' && kubectl get "$item" --output=json | jq -r -S '.metadata.labels | to_entries | .[] | " \(.key)=\(.value)"' 2>/dev/null; printf "\n"; done

# 列出当前pod正在使用的所有secert
kubectl get pods -o json | jq '.items[].spec.containers[].env[]?.valueFrom.secretKeyRef.name' | grep -v null | sort | uniq


# 列出pod资源配置
kubectl get deploy -n general-components -o jsonpath='{range .items[*]}{@.spec.replicas},{range @.spec.template.spec.containers[*]}{@.name},{@.resources.requests.cpu}C/{@.resources.requests.memory},{@.readinessProbe.httpGet.path},{@.readinessProbe.httpGet.port}{"\n"}{end}{end}'|sort -t ','  -k 2 |sed '1i副本数,项目,单节点资源,健康地址,端口' >general-components.csv

kubectl get deploy -n english-prod -o jsonpath='{range .items[*]}{@.spec.replicas},{range @.spec.template.spec.containers[*]}{@.name},{@.resources.requests.cpu}C/{@.resources.requests.memory},{@.readinessProbe.httpGet.path},{@.readinessProbe.httpGet.port}{"\n"}{end}{end}'|sort -t ','  -k 2 |sed '1i副本数,项目,单节点资源,健康地址,端口' |awk -F',' '{printf"%s %40-s %20-s %10-s\n",$1,$2,$3,$4}'
范例:kafka topic容量
# topic每个分区的容量
/usr/hdp/3.1.0.0-78/kafka/bin/kafka-log-dirs.sh --describe --bootstrap-server 172.18.41.174:9092|grep '^{' |jq '{a:.brokers[]|.logDirs[]|.partitions[]|{"partition","size"}}|.a'
/usr/hdp/3.1.0.0-78/kafka/bin/kafka-log-dirs.sh --describe --bootstrap-server 172.18.41.174:9092|grep '^{'   | jq '[ ..|.partition?,.size?]'

# topic每个分区的容量排序
/usr/hdp/3.1.0.0-78/kafka/bin/kafka-log-dirs.sh --describe --bootstrap-server 172.18.41.174:9092|grep '^{'   | jq '[ ..|.partition?,.size?]' |tr ',' ' '|grep -vE '\[|\]|null'|awk 'BEGIN{t=0}{if ($1 ~ "[a-zA-Z]") {t =$1}else{print t":"$1} }' |awk -F: '{num[$1]=$2}END{for(n in num)print n":"num[n]}'|sort -t: -nr -k1

/usr/hdp/3.1.0.0-78/kafka/bin/kafka-log-dirs.sh --describe --bootstrap-server 172.18.41.174:9092|grep '^{'   | jq '[ ..|.partition?,.size?]' |tr ',' ' '|grep -vE '\[|\]|null'|awk 'BEGIN{t=0}{if ($1 ~ "[a-zA-Z]") {t =$1}else{print t":"$1} }' |awk -F: '{num[$1]=$2}END{for(n in num)print n":"num[n]/1024/1024/1024"g"}'|sort -t: -nr -k2|grep -E 'xymember|yzuser|box|rainbowbridge|yzcrm'
范例:
#echo '查询用的github,GFW原因可能会比较久,请确保能访问到github'
curl -sX GET https://api.github.com/repos/zhangguanzhang/${repository}/contents/$img_name?ref=develop | \
    jq -r 'length as $len | if $len ==2 then .message elif $len ==12 then .name else .[].name  end'
练习
- 找出ifconfig "网卡名" 命令结果中本机的IPv4地址
- 查出分区空间使用率的最大百分比值
- 查出用户UID最大值的用户名、UID及shell类型
- 查出/tmp的权限,以数字方式显示
- 统计当前连接本机的每个远程主机IP的连接数,并按从大到小排序
yaml 文件分析工具 yq
yaml 语法
- X 分钟速成 Y
-
yaml 文件中多行字符串可以使用
|保留换行符,或者使用>将换行符替换为空格。其中,这两个换行符有以下几种用法:|:文中自动换行,默认仅保留一行空行|+:文中自动换行,保留字符串后面所有的空行|-:文中自动换行,删除字符串后面所有的空行>:文中不自动换行,默认仅保留一行空行>+:文中不自动换行,保留字符串后面所有的空行>-:文中不自动换行,删除字符串后面所有的空行
yq
yamlfmt 格式化 yaml 文档
安装 yamlfmt
wget https://github.com/google/yamlfmt/releases/download/v0.21.0/yamlfmt_0.21.0_Linux_x86_64.tar.gz

tar xzf yamlfmt_0.21.0_Linux_x86_64.tar.gz yamlfmt
mv yamlfmt /usr/local/bin/
rm yamlfmt*.tar.gz
安装 yq
wget https://github.com/mikefarah/yq/releases/latest/download/yq_linux_amd64 -O /usr/local/bin/yq &&\
    chmod +x /usr/local/bin/yq
# 导出为不同类型文件
-o, --output-format string            [auto|a|yaml|y|json|j|kyaml|ky|props|p|csv|c|tsv|t|xml|x|base64|uri|toml|hcl|h|shell|s|lua|l|ini|i] output format type. (default "auto")
使用与 jq 类似
范例:只读,不修改文件
cat <<\EOF>> demo.yaml
images:
  - name: wallet-chain
    newName: registry.example.com/wallet-chain
    newTag: v1.0.0
replica: 2
metadata:
  labels:
    env: dev
EOF

#读取顶层字段
yq '.replica' demo.yaml

#读取嵌套
yq '.metadata.labels.env' demo.yaml

#读取数组第0个元素
yq '.images[0].newTag' demo.yaml

#遍历数组全部元素
yq '.images[]' demo.yaml
范例:就地修改 -i
# -i = in-place 直接修改文件,输出写入原 yaml。

#字符串,必须双引号
yq -i '.metadata.labels.env = "prod"' demo.yaml
#数字不要引号
yq -i '.replica = 3' demo.yaml


# 修改 kustomization.yaml 镜像 tag
cat <<\EOF>> overlay/dev/kustomization.yaml
images:
  - name: registry.example.com/wallet-chain
    newName: registry.example.com/wallet-chain
    newTag: v1.0.0
EOF

#写法1:硬编码
yq -i '.images[0].newTag="v1.0.1"' overlays/dev/kustomization.yaml

#写法2:读取环境变量(Jenkins推荐,避开引号转义问题)
export NEW_TAG="v1.0.2"
yq -i '.images[0].newTag=strenv(NEW_TAG)' overlays/dev/kustomization.yaml


# 一次多处修改(管道 | 串联多个操作)
yq -i '
.images[0].newTag=strenv(NEW_TAG) |
.metadata.labels.version = strenv(NEW_TAG)
' demo.yaml


# 数组追加元素 +=
#追加一条env
yq -i '.spec.template.spec.containers[0].env += {"name":"DEBUG","value":"on"}' deploy.yaml


# 按条件筛选数组元素修改(select,非常实用)
yq -i '(.images[] | select(.name == "wallet-chain") | .newTag)="v2.0"' kustomization.yaml


# 删除字段 del ()
yq -i 'del(.metadata.labels.old-key)' demo.yaml
范例: 多文档 YAML(用 — 分隔多条 k8s 资源,eval‑all /ea)
cat <<\EOF>> manifests.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app1
---
apiVersion: v1
kind: Service
metadata:
  name: svc1
EOF

#取出所有Deployment名称
yq ea 'select(.kind=="Deployment")|.metadata.name' manifests.yaml
正则表达式
REGEXP: Regular Expressions,由一类特殊字符及文本字符所编写的模式,其 中有些字符(元字符)不表示字符字面意义,而表示控制或通配的功能,类似于 增强版的通配符功能,但与通配符不同,通配符功能是用来处理文件名,而正则 表达式是处理文本内容中字符
正则表达式被很多程序和开发语言所广泛支持:vim, less,grep,sed,awk, nginx,mysql 等
正则表达式分两类:
- 基本正则表达式:BRE
- 扩展正则表达式:ERE
正则表达式引擎:
采用不同算法,检查处理正则表达式的软件模块,如:PCRE(Perl Compatible RegularExpressions)
正则表达式的元字符分类:字符匹配、匹配次数、位置锚定、分组
帮助:man 7 regex 参考
- 正则表达式30分钟入门教程 https://www.w3cschool.cn/regex_rmjc/
- perl文官正则: https://perldoc.perl.org/perlre
- grep 中正则: https://www.gnu.org/software/grep/manual/grep.html#Regular-Expressions
- python re正则表达式: https://docs.python.org/zh-cn/3/library/re.html
- Microsoft
- 基础正则表达式: https://www.cnblogs.com/f-ck-need-u/p/9621130.html
- Perl正则表达式超详细教程: https://www.cnblogs.com/f-ck-need-u/p/9648439.html
测试:
- 正则测试工具RegEx Tester: https://sourceforge.net/projects/regextester/
- 在线测试:https://regextester.github.io/
基本正则表达式元字符
元字符
.:匹配任意单个字符,可以是一个汉字。但不能匹配换行符 \n。中括号[]中的.点表示点字符
*:匹配前面那个字符0或多次
?:匹配前面那个字符0或一次,即:可有可无
+:匹配前面那个字符1次以上,即:肯定有,>=1
{n}: 匹配前面的字符n次
{n,}: 匹配前面的字符至少n次
{,n}: 匹配前面的字符至多n次,<=n
{n,m}: 匹配前面的字符至少m次,至多n次

锚定:锚定的意思是匹配位置,而非匹配字符实体
  ^:匹配行首位置,注意匹配的是位置,不是字符
  $:匹配行尾位置,注意匹配的是位置,不是字符

特殊且常用的的组合正则表达式:
^$:它表示匹配空行
.*:匹配任意长度的任意字符,但不能匹配换行符。真正的匹配任意长度的任意字符,见下面


[]  匹配指定范围内的任意单个字符,示例:[wang]  [0-9]  [a-z]  [a-zA-Z]  [.]点放在中括号内表示.点,外面则是代表任意一个字符
[^] 匹配指定范围外的任意单个字符,示例:[^wang]
需要解释清楚的是这些量词(也就是上面匹配的次数元字符)的特殊性:当使用了
匹配多次的量词时(如匹配3-5次的 {3,5} ),且量词前面的字符有多种可能性
(如中括号序列 [abc] ),那么量词的次数可以作用于任一字符。有些不好理解,
但看示例就知道了:
[abc]{3,5}     # 表示abc任意字符都可以出现,比如全是a,或者ab同时出现,但总的出现次数为3-5次
.*          # 表示任一字符(除换行符),可以任意出现任意次数,它不表示a之后就必须全是a
.+          # 表示任一字符(除换行符),可以任意出现至少一次,它不表示a之后就必须全是a
另外, . 无法匹配换行符。可能你不太理解为什么需要匹配换行符,它主要用在:
- 多行模式。例如sed的多行模式下,要跨行匹配需要手动指定”\n“,如
/^a.*\nb.*/ - 明确指定了行分隔符为非”\n“的情况。例如awk可以使用RS变量指定输入行分隔符
范例:点
[root@centos8 ~]#ls /etc/ | grep 'rc[.0-6]'  # 点放在中括号内表示.点,外面则是代表任意一个字符
rc0.d
rc1.d
rc2.d
rc3.d
rc4.d
rc5.d
rc6.d
rc.d
rc.local
[root@centos8 ~]#ls /etc/ | grep 'rc[.0-6].'
rc0.d
rc1.d
rc2.d
rc3.d
rc4.d
rc5.d
rc6.d
rc.d
rc.local
[root@centos8 ~]#ls /etc/ | grep 'rc[.0-6]\.'
rc0.d
rc1.d
rc2.d
rc3.d
rc4.d
rc5.d
rc6.d
范例: 匹配次数
[root@middle-ware ~]# echo google |grep 'go*gle'
google
[root@middle-ware ~]# echo ggle |grep 'go*gle'   # *前面的字符任意次,包含0次,所以满足
ggle
[root@middle-ware ~]# echo goooogle |grep 'go*gle'
goooogle
[root@middle-ware ~]# echo ggle |grep 'g.*gle'
ggle
范例:
[root@centos8 ~]#echo /etc/ |grep "/etc/\?"
/etc/
[root@centos8 ~]#echo /etc |grep "/etc/\?"
/etc
中括号
中括号表示的是匹配任意一个,一般它和字符集的排序规则有关,不同工具采取的排序规则可能也不一样。
[]  匹配指定范围内的任意单个字符,示例:[wang]  [0-9]  [a-z]  [a-zA-Z]  [.]点放在中括号内表示.点,外面则是代表任意一个字符
[^] 匹配指定范围外的任意单个字符,示例:[^wang]
[abcd...]:匹配中括号内的任意一个字符
[^abcd...]:拒绝匹配中括号内的任意字符
[a-z]:匹配a到z间任意一个字符,
[A-Z]:匹配A到Z间任意一个字符
[0-9]:匹配0到9之间任意一个数字

常用组合:
[a-zA-Z0-9] : 匹配aA到zZ、0到9之间任意一个。如[abcxyz]表示从abcxyz中匹配任意一个字符
关于字母的排序:
- perl中,A-Z排在a的前面,所以[A-z]表示所有大小写字母
- grep中,A-Z排在z的后面,所以[a-Z]表示所有大小写字母
- 还有些工具中,大小写的排序规则是aAbBcC…zZ,所以[a-C]表示aAbBcC共6个字母
字符类
是专门命名的中括号序列;除了字符类,还有等价类、排序类,但基本用不上,只用字符类。
[:alpha:]:匹配字母(阿额儿发,等价于[a-zA-Z]
[:digit:]:匹配数字,等价于[0-9]
[:xdigit:]:匹配十六进制数,等价于[0-9a-fA-F]
[:upper:]:匹配大写字母(阿坡儿额),等价于[A-Z]
[:lower:]:匹配小写字母(路我额),等价于[a-z]
[:alnum:]:匹配数字或字母,等价于[0-9a-zA-Z]
[:blank:]:匹配空白,包括空格和制表符
[:space:]:匹配空格,包括新行、空格、制表符、换行符、回车符等各种类型的空白
[:punct:]:匹配所有标点符号(怕可特。包括:! ' " ` # $ % & ( ) * + , . - _ / : ; < = > ? @ [ \ ] ^ { | } ~
[:graph:]:非空字符。绘图类。包括:大小写字母、数字和标点符号。等价于[:alnum:]+[:punct:]
[:print:]:非空字符(包括空格)。打印字符类。包括:大小写字母、数字、标点符号和空格。等价于[:alnum:]+[:punct:]+space
[:cntrl:]:控制字符类。在ASCII中,这些字符的八进制代码从000到037,还包括177(DEL)。代表键盘上的控制键,包括 CR, LF, TAB, Del ..等
[:blank:]: 空白字符:空格和制表符
需要注意的是,通常字符类在真正使用过程中,会再加上一个中括号,例如 [[:alpha:]] 。

之所以如此,是因为这些字符类只是一种命名好的字符集合。

例如 [:lower:] 对应的字符集合是a-z,而不是 [a-z] ,所以要想让其表示这些命名字符类中的任一字符,需要再加上一层括号 [[:lower:]],它才等价于[a-z]。

可能会更有助于理解使用字符类的时候为什么要加两个中括号的例子是[^[:lower:]],它表示不包含任何小写字母。
反斜线序列
不同的工具,同一工具不同的版本,支持的反斜线序列能力不同。以下列出了部 分常见序列。
以下所说的单词,一般来说只包含数字、字母和下划线,即 [_0-9a-zA-Z] 。
以下几种反斜线序列,基本上所有工具都支持:
\b:匹配单词边界处的空字符
\B:匹配非单词边界处的空字符
\<:匹配单词开头处的空字符
\>:匹配单词结尾处的空字符
\w:匹配单词构成部分,等价于[_[:alnum:]]
\W:匹配非单词构成部分,等价于[^_[:alnum:]]
以下几种,有些工具不支持,但perl都支持:
\s:匹配空白字符,等价于[[:space:]]
\S:匹配非空白字符,等价于[^[:space:]]
\d:匹配数字,等价于[0-9]
\D:匹配非数字,等价于[^0-9]
由于元字符=.=默认无法匹配换行符,所以需要匹配换行符的时候,可以使用特
殊组合 [\d\D] 来替换 . ,换句话说,如果想匹配任意长度的任意字符,
可以换成 [\d\D]* ,当然,前提是必须支持 \d 和 \D 两个反斜线序列。
范例:使用正则工具或者在线正则网站测试
abc xyz
123
中文
. #非多行和单行下,默认匹配除换行符之外任意一个字符
\w\w #匹配2个字符
\d #匹配1个数字
[abc ] #匹配abc和空格中任意一个字符
[abc\s] #匹配abc和空格字符中任意一个字符
\w\s\w #匹配c x和z换行1和3换行中
[\d\s\d] #相当于[\d\s] 匹配数字和空白字符中任意字符
\b\w\w\b #即作词首又作词尾,匹配中文
分组捕获和反向引用
分组
分组: () 将多个字符捆绑在一起,当作一个整体处理,如: (root)+
后向引用:分组括号中的模式匹配到的内容会被正则表达式引擎记录于内部的变
量中,这些变量的命名方式为: \1, \2, \3, ...
\1 表示从左侧起第一个左括号以及与之匹配右括号之间的模式所匹配到的字符
基础正则中,使用括号可以对匹配内容进行分组并暂时保存,分组后会有分组编
号,可以使用反斜线加编号 \N 的方式反向引用这些分组。
分组编号的方式是从左向右计算括号数,无论如何嵌套,第一个左括号对应的分
组一定是编号1,用 \1 来引用,第二个左括号对应的分组一定是编号2,用
\2 来引用,依此类推。
示例:
\(string1\(string2\)\)
\1 :string1\(string2\)
\2 :string2
echo "abcddefg" | grep -E "(.)\1"
对于只使用基础正则的工具来说,一般都只能引用 \1 到 \9 共9个反向引
用,最多自己额外提供一个所有表示匹配内容的反向引用(例如sed提供的 & )。
对于超出10个的分组,使用基础正则的工具一般来说是无能为力的。
再者,基础正则仅仅只是将分组匹配到的内容捕获,在正则操作结束后就丢失。 但对于一门完整编程语言来说,这远远不够,几乎所有编程语言(如 perl/java/python等)都会将正则的分组匹配内容保存为变量,使得可以在正则 结束之后再次引用甚至修改它们。例如上面例子中分组捕获的字母d,如果换成 perl,即使在这个匹配过程结束后,还是可以去引用这段分组。
或者
pattern1 | pattern2:匹配竖线左边,或者匹配竖线右边都算匹配成功
几点需要说明:
- 因为竖线元字符的优先级很低,所以
ab|cd匹配的是”ab”或”cd”,而 不是abd或acd。 - 成功匹配了左边,就不会再去对右边进行匹配。
- 反向引用失败问题:竖线将两边的分组隔开,右边的永远无法反向引用左边 的分组
示例:
a\|b #a或b
C\|cat #C或cat
\(C\|c\)at #Cat或cat

两个反向引用问题的典型例子:
例如a(.)|b\1将无法匹配"ba",因为评估了左边就不会评估右边。
例如([ac])e\1|b([xyz])\2t的左边能匹配aea或cec,但不能匹配cea或aec,右边能匹配bxxt或byyt或bzzt。但如果将\2换成\1,即([ac])e\1|b([xyz])\1t,将无法匹配b[xyz]at或b[xyz]ct,因为第一个分组括号在左边,无法参与右边的正则评估。
范例:排除空行和#开头的行
[root@centos6 ~]#grep -v '^#' /etc/httpd/conf/httpd.conf |grep -v ^$
[root@centos6 ~]#grep -v '^#\|^$' /etc/httpd/conf/httpd.conf
[root@centos6 ~]#grep -v '^\(#\|$\)' /etc/httpd/conf/httpd.conf
[root@centos6 ~]#grep "^[^#]" /etc/httpd/conf/httpd.conf
正则表达式练习
- 显示/proc/meminfo文件中以大小s开头的行(要求:使用两种方法)
- 显示/etc/passwd文件中不以/bin/bash结尾的行
- 显示用户rpc默认的shell程序 4、找出/etc/passwd中的两位或三位数
- 显示CentOS7的/etc/grub2.cfg文件中,至少以一个空白字符开头的且后面有非空白字符的行
- 找出“netstat -tan”命令结果中以LISTEN后跟任意多个空白字符结尾的行
- 显示CentOS7上所有UID小于1000以内的用户名和UID
- 添加用户bash、testbash、basher、sh、nologin(其shell为/sbin/nologin),找出/etc/passwd用户名和shell同名的行
- 利用df和grep,取出磁盘各分区利用率,并从大到小排序
1、显示/etc/passwd文件中不以/bin/bash结尾的行; ~]# grep -v "/bin/bash$"
/etc/passwd

2、找出/etc/passwd文件中的两位数或三位数; ~]# grep "<[[:digit:]]{2,3}>"
/etc/passwd 或 grep '^<[0-9]{2,3}>' /etc/passwd

3、找出/etc/rc.d/rc.sysinit或/etc/grub2.cfg文件中,以至少一个空白字符开头,且后面非空白字符的行;
~]# grep "[fn:1]+[[fn:2]]" /etc/grub2.cfg

4、找出”netstat
-tan”命令的结果中以”LISTEN”后跟0、1或多个空白字符结尾的行; ~]# netstat
-tan | grep “LISTEN[[:space:]]*$”

过滤空行和开始为#开始的行 grep -Ev '^{#|}$' /etc/fstab

只在目录中所有的.php和.html文件中递归搜索字符”main()”

- grep "main()" . -r --include *.{php,html}

只在目录中所有的.php和.html文件中递归搜索字符”main()”

- grep "main()" . -r --include *.{php,html}

在搜索结果中排除filelist文件列表里的文件

- grep "main()" . -r --exclude-from filelist

搜索多个文件并查找匹配文本在哪些文件中

- grep -l "root" /etc/fstab /etc/passwd

搜索开头不是英文字母的行,并显示行号

- grep -n '[fn:3]' /etc/fstab

查找default和dev两个关键字

- grep -e "defaulkt" -e "dev" /etc/fstab

查找/etc目录下,所有包含root关键字的文件并显示文件路径及文件名

- grep -lr "root" /etc/ | xargs ls -l

监控日志文档中产生Error的行,并只打印包含Error的行

- tail -f /var/www/logs/error.log | grep --line-buffered "Error"
基本正则表达式与扩展正则表达式
在GNU grep 中,基本正则表达式和扩展正则表达式只是同一模式匹配功能的
不同符号。在其他实现中,基本正则表达式通常不如扩展的强大,但有时情况正
则相反。以下说明适用于扩展正则表达式;下面总结了基本正则表达式的差异。
https://www.gnu.org/software/grep/manual/grep.html#Basic-vs-Extended-Regular-Expressions
'?', '+', '{', '|', '(', and ')基本正则前面要加\
字符匹配元字符
基本正则
[]  匹配指定范围内的任意单个字符,示例:[wang]  [0-9]  [a-z]  [a-zA-Z]  [.]点放在中括号内表示.点,外面则是代表任意一个字符
[^] 匹配指定范围外的任意单个字符,示例:[^wang]

匹配指定范围有以下几种:
[a-z] : 匹配a到z间任意一个字符,
[A-Z] : 匹配A到Z间任意一个字符,
[0-9] : 匹配0到9之间任意一个数字
[a-zA-Z0-9] : 匹配aA到zZ、0到9之间任意一个,。如[abcxyz]表示从abcxyz中匹配任意一个字符
[[:upper:]] :所有大写字母(阿坡儿额) [A-Z]
[[:lower:]] : 所有小写字母(路我额) [a-z]
[[:alpha:]] : 所有字母(阿额儿发)  [a-zA-Z]
[[:digit:]] : 十进制数字 [0-9]
[[:alnum:]] : 所有字母和数字(埃奥number)  [0-9a-zA-Z]
[[:space:]] : 所有空白字符(新行,空格,制表符 )
[[:punct:]] : 所有标点符号(怕可特),'! " # $ % & ' ( ) * + , - . / : ; < = > ? @ [ \ ] ^ _ ' { | } ~'
[[:xdigit:]] :  任何16进制的数字,相当于[0-9a-fA-F]

[[:cntrl:]] :  代表键盘上的控制键,包括 CR, LF, TAB, Del ..等
[[:graph:]] : 非空字符。除了空白键和 Tab键外的其他所有按键,相当于'[:alnum:]' +'[:punct:]'.
[[:print:]] : 非空字符(包括空格)。代表任何可被打印字符,相当于  '[:alnum:]', '[:punct:]', 和space.
[[:ascii:]] :
[[:blank:]] :   代表空白键与TAB键两者
[[:word:]] :

[_[:alnum:]] : 表示除了 alnum 还多了一个字符 _ 下划线
扩展正则
. 任意单个字符
[wang] 指定范围的字符
[^wang] 不在指定范围的字符
[:alnum:] 字母和数字
[:alpha:] 代表任何英文大小写字符,亦即 A-Z, a-z
[:lower:] 小写字母,示例:[[:lower:]],相当于[a-z]
[:upper:] 大写字母
[:blank:] 空白字符(空格和制表符)
[:space:] 水平和垂直的空白字符(比[:blank:]包含的范围广)
[:cntrl:] 不可打印的控制字符(退格、删除、警铃...)
[:digit:] 十进制数字
[:xdigit:]十六进制数字
[:graph:] 可打印的非空白字符
[:print:] 可打印字符
[:punct:] 标点符号
次数匹配
用在要指定次数的字符后面,用于指定前面的字符要出现的次数
基本正则
* 匹配前面的字符任意次,包括0次,贪婪模式:尽可能长的匹配
.* 任意长度的任意字符
\? 匹配其前面的字符0或1次,即:可有可无
\+ 匹配其前面的字符至少1次,即:肯定有,>=1
\{n\} 匹配前面的字符n次
\{m,n\} 匹配前面的字符至少m次,至多n次
\{,n\} 匹配前面的字符至多n次,<=n
\{n,\} 匹配前面的字符至少n次
扩展正则
*  匹配前面字符任意次
? 0或1次
+ 1次或多次
{n} 匹配n次
{m,n} 至少m,至多n次
位置锚定
位置锚定可以用于定位出现的位置
基本正则
a) 在行的位置锚定
^ : 脱字符,行首锚定;用于模式的最左侧;如,匹配行首出现root,grep '^root'
$ : 行尾锚定;用于模式的最右侧;如,匹配行尾出现root,grep '$root'
^PATTERN$:用模式PATTERN来匹配整行;如,匹配整行只有root,grep '^root$'
    ^$ : 空白行;
    ^[[:space:]]*$ : 空行或包含空白字符的行;


b) 在单词的位置锚定
\< 或 \b : 词首锚定,用于单词模式的左侧;如,grep "\<word"
\> 或 \b : 词尾锚定,用于单词模式的右侧;如,grep "word\>"
\<PATTERN\> : 匹配完整单词;精确锚定单词;如,grep "\<word\>
扩展正则
^ 行首
$ 行尾
\<, \b 语首
\>, \b 语尾
范例:排除掉空行和#开头的行
[root@centos8 ~]#grep -v '^$' /etc/profile|grep -v '^#'
分组其它
分组: () 将多个字符捆绑在一起,当作一个整体处理,如: (root)+
后向引用:分组括号中的模式匹配到的内容会被正则表达式引擎记录于内部的变
量中,这些变量的命名方式为: \1, \2, \3, ...
\1 表示从左侧起第一个左括号以及与之匹配右括号之间的模式所匹配到的字符
注意: 后向引用引用前面的分组括号中的模式所匹配字符,而非模式本身
基本正则
\(string1\(string2\)\)
\1 :string1\(string2\)
\2 :string2


a\|b #a或b
C\|cat #C或cat
\(C\|c\)at #Cat或cat
扩展正则
() 分组
后向引用:\1, \2, ...
| 或者
a|b #a或b
C|cat #C或cat
(C|c)at #Cat或cat
vim 扩展模式
将rxxt后加上er  :%s#\(r..t\)#\1er#g
保留文件非#号开头的其它字符:
:%s/^#\(.*\)/\1/g
或
:%s/^#//g
扩展正则表达式练习
- 显示三个用户root,cici,wang的UID和默认shell
- 找出/etc/rc.d/init.d/functions文件中行首为某单词(包括下划线)后面跟一个小括号的行
- 使用egrep取出/etc/rc.d/init.d/functions中其基名
- 使用egrep取出上面路径的目录名
- 统计last命令中以root登录的每个主机IP地址登录次数
- 利用扩展正则表达式分别表示0-9、10-99、100-199、200-249、250-255
- 显示ifconfig命令结果中所有IPv4地址
- 将此字符串:welcome to me linux 中的每个字符去重并排序,重复次数多的 排到前面
1、找出/proc/meminfo文件中,所有以大写或小写S开头的行;至少有三种实现方式;
grep "^[sS]" /proc/meminfo
grep -i "^s" /proc/meminfo
grep -E "^(s|S)" /proc/meminfo
grep -E "^s|^S" /proc/meminfo

2、显示当前系统上root、centos或者user1用户的相关信息;
~]# grep -E "^(root|centos|user1\>)" /etc/passwd

3、找出/etc/rc.d/init.d/functions文件中某单词后跟一个小括号的行;
~]# grep -Eo '[_[:alnum:]]+\(\)' /etc/rc.d/init.d/functions
[_[:alnum:]] : 表示除了 alnum 还多了一个字符 _ 下划线

[root@node01 ~]# grep -Eo  "[_[:alnum:]]+\(\)" /etc/init.d/functions
checkpid()
__pids_pidof()
is_false()
apply_sysctl()
... ...


4、使用echo命令输出一绝对路径,使用egrep取出基名;
echo "/root/ssf/erou/dfjl" | egrep -o "\<[[:alpha:]]*\>$"
echo "/root/ssf/erou/dfjl" | grep -Eo "[^/]+/?$"   # 锚定行尾的非斜线字符,行尾 / 可有可无

5、找出ifconfig命令结果中的1-255之间的数值;
ifconfig | grep -oE "\<([1-9] | [1-9][0-9] | 1[0-9]{2} | 2[0-4][0-9] | 25[0-5])\>"

6、课外作业:找出ifconfig命令结果中的IP地址;
[root@node01 ~]# ip -o -4 addr list ens33 | perl -n -e 'if (m{inet\s([\d\.]+)\/\d+\s}xms) { print $1 }'
172.16.100.6


[root@node01 ~]# ifconfig  | grep -o '\([0-9]\{1,3\}\.\)\{3\}[0-9]\{1,3\}'
172.17.0.1
255.255.0.0
0.0.0.0
172.16.100.6
255.255.0.0
172.16.255.255
127.0.0.1
255.0.0.0
[root@node01 ~]# ifconfig | grep -o '\b[0-9]\{1,3\}\b\.\b[0-9]\{1,3\}\b\.\b[0-9]\{1,3\}\b\.\b[0-9]\{1,3\}\b'
172.17.0.1
255.255.0.0
0.0.0.0
172.16.100.6
255.255.0.0
172.16.255.255
127.0.0.1
255.0.0.0
[root@node01 ~]# ifconfig  | grep -Po '(?<=inet)(.*)(?=net)'
172.17.0.1
172.16.100.6
127.0.0.1

7、添加用户bash, testbash, basher以及nologin(其shell为/sbin/nologin);而后找出/etc/passwd文件中用户名同shell名的行;
~]# grep  -E  "^([^:]+\>).*\1$"  /etc/passwd
20个正则表达式
正则表达式经常被用于字段或任意字符串的校验,如下面这段校验基本日期格式 的JavaScript代码:
var reg = /^(\\d{1,4})(-|\\/)(\\d{1,2})\\2(\\d{1,2})$/;
var r = fieldValue.match(reg);
if(r==null)alert('Date format error!');
下面是技匠整理的,在前端开发中经常使用到的20个正则表达式。
1 . 校验密码强度
密码的强度必须是包含大小写字母和数字的组合,不能使用特殊字符,长度在8-10之间。
^(?=.*\\d)(?=.*[a-z])(?=.*[A-Z]).{8,10}$

2. 校验中文
字符串仅能是中文。
^[\\u4e00-\\u9fa5]{0,}$

3. 由数字、26个英文字母或下划线组成的字符串
^\\w+$
4. 校验E-Mail 地址
同密码一样,下面是E-mail地址合规性的正则检查语句。
[\\w!#$%&'*+/=?^_`{|}~-]+(?:\\.[\\w!#$%&'*+/=?^_`{|}~-]+)*@(?:[\\w](?:[\\w-]*[\\w])?\\.)+[\\w](?:[\\w-]*[\\w])?

5. 校验身份证号码
下面是身份证号码的正则校验。15 或 18位。
15位:
^[1-9]\\d{7}((0\\d)|(1[0-2]))(([0|1|2]\\d)|3[0-1])\\d{3}$
18位:
^[1-9]\\d{5}[1-9]\\d{3}((0\\d)|(1[0-2]))(([0|1|2]\\d)|3[0-1])\\d{3}([0-9]|X)$

6. 校验日期
“yyyy-mm-dd“ 格式的日期校验,已考虑平闰年。
^(?:(?!0000)[0-9]{4}-(?:(?:0[1-9]|1[0-2])-(?:0[1-9]|1[0-9]|2[0-8])|(?:0[13-9]|1[0-2])-(?:29|30)|(?:0[13578]|1[02])-31)|(?:[0-9]{2}(?:0[48]|[2468][048]|[13579][26])|(?:0[48]|[2468][048]|[13579][26])00)-02-29)$

7. 校验金额
金额校验,精确到2位小数。
^[0-9]+(.[0-9]{2})?$

8. 校验手机号
下面是国内 13、15、18开头的手机号正则表达式。(可根据目前国内收集号扩展前两位开头号码)
^(13[0-9]|14[5|7]|15[0|1|2|3|5|6|7|8|9]|18[0|1|2|3|5|6|7|8|9])\\d{8}$

9. 判断IE的版本
IE目前还没被完全取代,很多页面还是需要做版本兼容,下面是IE版本检查的表达式。
^.*MSIE [5-8](?:\\.[0-9]+)?(?!.*Trident\\/[5-9]\\.0).*$

10. 校验IP-v4地址
IP4 正则语句。
\\b(?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\\b

11. 校验IP-v6地址
IP6 正则语句。
(([0-9a-fA-F]{1,4}:){7,7}[0-9a-fA-F]{1,4}|([0-9a-fA-F]{1,4}:){1,7}:|([0-9a-fA-F]{1,4}:){1,6}:[0-9a-fA-F]{1,4}|([0-9a-fA-F]{1,4}:){1,5}(:[0-9a-fA-F]{1,4}){1,2}|([0-9a-fA-F]{1,4}:){1,4}(:[0-9a-fA-F]{1,4}){1,3}|([0-9a-fA-F]{1,4}:){1,3}(:[0-9a-fA-F]{1,4}){1,4}|([0-9a-fA-F]{1,4}:){1,2}(:[0-9a-fA-F]{1,4}){1,5}|[0-9a-fA-F]{1,4}:((:[0-9a-fA-F]{1,4}){1,6})|:((:[0-9a-fA-F]{1,4}){1,7}|:)|fe80:(:[0-9a-fA-F]{0,4}){0,4}%[0-9a-zA-Z]{1,}|::(ffff(:0{1,4}){0,1}:){0,1}((25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])\\.){3,3}(25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])|([0-9a-fA-F]{1,4}:){1,4}:((25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])\\.){3,3}(25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9]))

12. 检查URL的前缀
应用开发中很多时候需要区分请求是HTTPS还是HTTP,通过下面的表达式可以取出一个url的前缀然后再逻辑判断。
if (!s.match(/^[a-zA-Z]+:\\/\\//))
{
    s = 'http://' + s;
}

13. 提取URL链接
下面的这个表达式可以筛选出一段文本中的URL。
^(f|ht){1}(tp|tps):\\/\\/([\\w-]+\\.)+[\\w-]+(\\/[\\w- ./?%&=]*)?

14. 文件路径及扩展名校验
验证windows下文件路径和扩展名(下面的例子中为.txt文件)
^([a-zA-Z]\\:|\\\\)\\\\([^\\\\]+\\\\)*[^\\/:*?"<>|]+\\.txt(l)?$

15. 提取Color Hex Codes
有时需要抽取网页中的颜色代码,可以使用下面的表达式。
^#([A-Fa-f0-9]{6}|[A-Fa-f0-9]{3})$

16. 提取网页图片
假若你想提取网页中所有图片信息,可以利用下面的表达式。
\\< *[img][^\\\\>]*[src] *= *[\\"\\']{0,1}([^\\"\\'\\ >]*)

17. 提取页面超链接
提取html中的超链接。
(<a\\s*(?!.*\\brel=)[^>]*)(href="https?:\\/\\/)((?!(?:(?:www\\.)?'.implode('|(?:www\\.)?', $follow_list).'))[^"]+)"((?!.*\\brel=)[^>]*)(?:[^>]*)>

18. 查找CSS属性
通过下面的表达式,可以搜索到相匹配的CSS属性。
^\\s*[a-zA-Z\\-]+\\s*[:]{1}\\s[a-zA-Z0-9\\s.#]+[;]{1}

19. 抽取注释
如果你需要移除HMTL中的注释,可以使用如下的表达式。
<!--(.*?)-->

20. 匹配HTML标签
通过下面的表达式可以匹配出HTML中的标签属性。
<\\/?\\w+((\\s+\\w+(\\s*=\\s*(?:".*?"|'.*?'|[\\^'">\\s]+))?)+\\s*|\\s*)\\/?>
Perl正则表达式超详细教程
关于基础正则表达式的内容请看上篇。
只介绍匹配操作,关于内容替换,因为和学习使用perl正则并无多大关系。
以下是perl正则的man文档:
- perl正则快速入门:man perlrequick
- perl正则教程:man perlretut
- perl正则完整文档:man perlre
学perl正则必备的一点基本语法
新建一个文件作为perl脚本文件,在其首行写上 #!/usr/bin/perl ,它表示用
perl作为本文件的解释器。写入一些perl程序后,再赋予执行权限就可以执行了,
或者直接使用perl命令去调用这个脚本文件,前面的两个过程都可以省略,这和
shell脚本的方式是完全一样的,无非是将bash替换为了perl,想必各位都理解。
1.print用来输出信息 ,相当于shell中的echo命令,但需要手动输入换行 符”\n“进行换行。
例如:
#!/usr/bin/perl

print "hello world\n";      # 注意每一句后面都使用分号结尾
保存后,执行它(假设脚本文件名为test.pl):
$ chmod +x test.pl
$ perl test.pl
2.变量赋值
perl中的变量可以不用事先声明,可以直接赋值甚至直接引用。注意变量名前面 总是需要加上$符号,无论是赋值的时候还是引用的时候,这和其它语言不太一 样。
#!/usr/bin/perl

$name="xiaoming";
$age=18;
print "$name $age \n";
3.if语句用来判断 ,语法格式为:
if(condition){
    body
}else{
    body
}
例如:
$age = 18;
if($age <= 20){
    print "age less than 20\n";
} else {
    print "age greate than 20\n";
}
4.默认参数变量
在perl中,对于需要参数的函数或表达式,但却没有给参数,这是将会使用perl
的默认参数变量 $_ 。
例如,下面的print本来是需要参数的,但是因为没有给参数,print将输出默认
的参数变量 $_ ,也就是输出”abcde”。
$_="abcde";
print ;
perl中使用 $_ 的地方非常多,后文还会出现,不过用到的时候我会解释。
5.读取标准输入
perl中使用一对尖括号格式的 <STDIN> 来读取来自非文件的标准输入,例如
来自管道的数据,来自输入重定向的数据或者来自键盘的输入。需要注意的是,
<STDIN> 读取的输入会自带换行符,所以print输出的时候不要加上额外的换
行符。
例如,在test.pl文件中写入如下内容:
#!/usr/bin/perl

$data=<STDIN>;
print "$data";
然后用管道传递一行数据给perl程序:
echo "abcdefg" | perl test.pl
只是需要注意,将 <STDIN> 赋值给变量时,将只能读取一行(遇到换行符就结
束读取)。例如下面的perl将读取不了”hijklmn”。
echo -e "abcdefg\nhijklmn" | perl test.pl
如果想要读取多行标准输入,就不能将其赋值给变量,而是使用foreach来遍历 各行(此处不介绍其它方式):
foreach $line (<STDIN>){
    print "$line";
}
以上就是foreach的语法:
- 圆括号中的内容是待遍历对象,通常是一个列表,比如上面用
<STDIN>读 取的多行数据就是一个列表,每一行都是列表中的一个元素; $line称为控制变量,foreach在每次迭代过程中都会选中一个列表中的元 素赋值给$line,例如将读取的每一行都赋值给$line。
可以省略 $line ,这时就采用默认的参数变量 $_ ,所以以下两个表达式
是等价的:
foreach (<STDIN>){
    print "$_";
}

foreach $_ (<STDIN>){
    print "$_";
}
6.读取文件中的数据
正则强大的用处就是处理文本数据,所以必须要说明perl如何读取文件数据来做 正则匹配。
我们可以将文件作为perl命令行的参数,perl会使用 <> 去读取这些文件中的内
容。
foreach (<>){
    print "$_";
}
执行的时候,只要把文件作为perl命令或脚本文件的参数即可:
perl test.pl /etc/passwd
7.去掉行尾分隔符
由于 <> 和 <STDIN> 读取文件、读取标准输入的时候总是自带换行符,很
多时候这个自带的换行符都会带来格式问题。所以,有必要在每次读取数据时将
行尾的换行符去掉,使用chomp即可。
例如:
foreach $line (<STDIN>) {
    chomp $line;
    print "$line read\n";
}
以下是执行结果:
# echo -e "xiaoming xiaohong" | perl 26.plx
xiaoming xiaohong read
如果上面的例子中不加上chomp,那么执行结果将像下面一样:
# echo -e "xiaoming xiaohong" | perl 26.plx
xiaoming xiaohong
 read
显然,输出格式和print语句中期待的输出格式不一样。
前面说过,可以省略 $line ,让其使用默认的参数变量 $_ ,所以可以这
样读取来自perl命令行参数文件的数据:
foreach (<>) {
    chomp;
    print "$_ read\n";
}
8.命令行的操作模式
其实就是一行式。perl命令行加上”-e”选项,就能在perl命令行中直接写perl 表达式,例如:
echo "xiaohong" | perl -e '$name=<STDIN>;print $name;'
因为perl最为人所知的就是它应用了各种符号的组合,让人看着怪异无比,而这 些符号放在命令行中很可能会被shell先解析,所以强烈建议”-e”后表达式使 用单引号包围,而不是双引号。
更建议,如果可以,不要使用perl命令行的方式,调试起来容易混乱。
perl如何使用正则进行匹配
使用 =~ 符号表示要用右边的正则表达式对左边的数据进行匹配。正则表达式
的书写方式为 m// 。关于 m// ,其中斜线可以替换为其它符号,规则如下:
- 双斜线可以替换为任意其它对应符号,例如对称的括号类,
m(),m{},相同的标点类,m!!,m%%等等 - 只有当m模式采用双斜线的时候,可以省略m字母,即
//等价于m// - 如果正则表达式中出现了和分隔符相同的字符,可以转义表达式中的符号,但
更建议换分隔符,例如
/http:\/\//转换成m%http://%
所以要匹配内容,有以下两种方式:
- 方式一:使用
data =~ m/reg/,可以明确指定要对data对应的内容进行正 则匹配 - 方式二:直接
/reg/,因为省略了参数,所以使用默认参数变量,它等价 于$_ =~ m/reg/,也就是对$_保存的内容进行正则匹配
perl中匹配操作默认返回的是匹配成功与否,成功则返回真,匹配不成功则返回
假。但是当使用了全局匹配修饰符 g ,则返回本次匹配成功的内容。此外,
perl提供了特殊变量允许访问匹配到的内容,甚至匹配内容之前的数据、匹配内
容之后的数据都提供了相关变量以便访问。见下面的示例。
例如:
1.匹配给定字符串内容
$name = "hello gaoxiaofang";
if ($name =~ m/gao/){
    print "matched\n";
}
或者,直接将字符串拿来匹配:
"hello gaoxiaofang" =~ m/gao/;
2.匹配来自管道的每一行内容,匹配成功的行则输出
foreach (<STDIN>){
    chomp;
    if (/gao/){
        print "$_ was matched 'gao'\n";
    }
}
上面使用了默认的参数变量 $_ ,它表示foreach迭代的每一行数据;上面还
简写的正则匹配方式 /gao/ ,它等价于 $_ =~ m/gao/ 。
以下是执行结果:
# echo -e "xiaoming gaoxiaofang" | perl 26.plx
xiaoming gaoxiaofang was matched 'gao'
3.匹配文件中每行数据
foreach (<>){
    chomp;
    if(/gao/){
        print "$_ was matched 'gao'\n";
    }
}
4.如果想要输出匹配到的内容,可以使用特殊变量 $& 来引用匹配到的内容,
还可以使用 $` 引用匹配前面部分的内容, $' 引用匹配后面部分的内容
例如:
aAbBcC =~ /bB/
由于匹配的内容是bB,匹配内容之前的部分是aA,匹配之后的部分是cC,于是可 以看作下面对应关系:
(aA)(bB)(cC)
 |    |   |
 $`   $&  $'
以下是使用这三个特殊变量的示例:
$name="aAbBcC";
if($name =~ /bB/){
    print "pre match: $` \n";
    print "match: $& \n";
    print "post match: $' \n";
}
需要注意的是,正则中一般都提供全局匹配的功能,perl中使用修饰符 /g 开启。
当开启了全局匹配功能,这3个变量保存的值需要使用循环语句去遍历,否则将
只保存第一次匹配的内容。例如:
$name="aAbBcCbB";
if($name =~ /bB/g){        # 匹配完第一个bB就结束
    print "pre match: $` \n";
    print "match: $& \n";
    print "post match: $' \n";
}

while($name =~ /bB/g){   # 将迭代两次
    print "pre match: $` \n";
    print "match: $& \n";
    print "post match: $' \n";
}
perl支持的正则
从这里开始,正式介绍perl支持的正则。
出于方便,我全部都直接在perl程序内部定义待匹配的内容,如果想要匹配管道 传递的输入,或者匹配文件数据,请看上文获取操作方法。
为了完整性,每一节中我都是先把一大堆的内容列出来做个简单介绍,然后再用 示例解释每个(或某几个)。但perl正则的内容太多,而且很多功能前后关联,所 以如果列出来的内容没有在同一小节内介绍,那么就是在后面需要的地方介绍。 当然,也有些没什么用或者用的很少的功能(比如unicode相关的),通篇都不会 介绍。
模式匹配修饰符
指定模式匹配的修饰符,可以改变正则表达式的匹配行为。例如,下面的i就是 一种修饰符,它让前面的正则REG匹配时忽略大小写。
m/REG/i
perl总共支持以下几种修饰符:msixpodualngc
i:匹配时忽略大小写
g:全局匹配,默认情况下,正则表达式"abc"匹配"abcdabc"字符串的时候,将之匹配左边的abc,使用g将匹配两个"abc"
c:在开启g的情况下,如果匹配失败,将不重置搜索位置
m:多行匹配模式
s:让.可以匹配换行符"\n",也就是说该修饰符让.真的可以匹配任意字符
x:允许正则表达式使用空白符号,免得让整个表达式难读难懂,但这样会让原本的空白符号失去意义,这是可以使用\s来表示空白
o:只编译一次正则表达式
n:非捕获模式
p:保存匹配的字符串到${^PREMATCH}、${^MATCH}、${^POSTMATCH}中,它们在结果上对应$`、$&和$',但性能上要更好
a和u和l:分别表示用ASCII、Unicode和Locale的方式来解释正则表达式,一般不用考虑这几个修饰符
d:使用unicode或原生字符集,就像5.12和之前那样,也不用考虑这个修饰符
这些修饰符可以连用,连用时顺序可随意。例如下面两行是等价的行为:全局忽 略大小写的匹配行为。
m/REG/ig
m/REG/gi
上面的修饰符,本节介绍igcmsxpo这几个修饰符,n修饰符在后面分组捕获的地 方解释,auld修饰符和字符集相关,不打算解释。
i修饰符:忽略大小写
该修饰符使得正则匹配的时候,忽略大小写。
$name="aAbBcC";
if($name =~ m/ab/i){
    print "pre match: $` \n";     # 输出a
    print "match: $& \n";         # 输出Ab
    print "post match: $' \n";    # 输出BcC
}
g和c修饰符以及\G
g修饰符(global)使得正则匹配的时候,对字符串做全局匹配,也就是说,即使 前面匹配成功了,还会继续向后匹配,看是否还能匹配成功。
例如,字符串”abcabc”,正则表达式”ab”,在默认情况下(不是全局匹配)该 正则在匹配到第一个ab后就结束了,如果使用了g修饰符,匹配完第一个ab,还 会继续向后匹配,而且正好还能匹配到第二个ab,所以最终有两个ab被匹配成功。
要验证多次匹配,需要使用循环遍历的方式,而不能用if语句:
$name="aAbBcCaBc";
while($name =~ m/ab/gi){
    print "pre match: $` \n";
    print "match: $& \n";
    print "post match: $' \n";
}
执行它,将输出如下内容:
pre match: a
match: Ab
post match: BcCaBc
pre match: aAbBcC
match: aB
post match: c
以下内容,如果仅仅只是为了学perl正则,那么可以跳过,因为很难,如果是学 perl语言,那么可以继续看下去。
实际上, 在开启了g全局匹配后 ,perl每次在 成功匹配 的时候都会记下 匹配的字符位移,以便在下次匹配该内容时候,可以从指定位移处继续向后匹配。 每次 匹配成功后 的位移值(pos的位移从0开始算,0位移代表的是第一个字符 左边的位置),都可以通过pos()函数获取。如果本次匹配导致位移指针重置, pos将返回undef。
$name="123ab456";
$name =~ m/\d\d/g;     # 第一次匹配,匹配成功后记下位移
print "matched string: $&, position: ",pos $name,"\n";
$name =~ m/\d\d/g;     # 第二次匹配,匹配成功后记下位移
print "matched string: $&, position: ",pos $name,"\n";
执行它,将输出如下内容:
matched string: 12, position: 2
matched string: 45, position: 7
由于匹配失败的时候,正则匹配操作会返回假,所以可以作为if或while等的条 件语句。例如,改为while循环多次匹配:
$name="123ab456";
while($name =~ m/\d\d/g){
    print "matched string: $&, position: ",pos $name,"\n";
}
默认全局匹配情况下,当本次匹配失败,位移指针将重置到起始位置0处,也就 是说,下次匹配将从头开始匹配。例如:
$txt="1234a56";
$txt =~ /\d\d/g;      # 匹配成功:12,位移向后移两位
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d/g;      # 匹配成功:34,位移向后移两位
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d\d/g;      # 匹配失败,位移指针回到0处,pos()返回undef
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/g;          # 匹配成功:1,位移向后移1位
print "matched $&: ",pos $txt,"\n";
执行上述程序,将输出:
matched 12: 2
matched 34: 4
matched 34:
matched 1: 1
如果”g”修饰符下同时使用”c”修饰符,也就是”gc”,它表示全局匹配失败 的时候不重置位移指针。也就是说,本次匹配失败后,位移指针会卡在原处不动, 下次匹配将从这个位置处开始匹配。
$txt="1234a56";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d\d/gc;   # 匹配失败,$&和pos()保留上一次匹配成功的内容
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/g;        # 匹配成功:5
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/g;        # 匹配成功:6
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/gc;        # 匹配失败
print "matched $&: ",pos $txt,"\n";
执行上述程序,将输出:
matched 12: 2
matched 34: 4
matched 34: 4
matched 5: 6
matched 6: 7
matched 6: 7
继续上面的问题,如果第三个匹配语句不是 \d\d\d ,而是”\d",它匹配字母a
的时候也失败,不用c修饰符的时候会重置位移吗?显然是不会。因为它会继续
向后匹配。所以该 \G 登场了。
默认全局匹配情况下,匹配时是可以跳过匹配失败的字符继续匹配的:当某个字 符匹配失败,它会后移一位继续去匹配,直到匹配成功或匹配结束。
$txt="1234ab56";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/g;       # 字母a匹配失败,后移一位,字母b匹配失败,后移一位,数值5匹配成功
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d/g;       # 数值6匹配成功
print "matched $&: ",pos $txt,"\n";
执行上述程序,将输出:
matched 12: 2
matched 34: 4
matched 5: 7
matched 6: 8
可以指定 \G ,使得本次匹配强制从位移处进行匹配,不允许跳过任何匹配失败的字符。
- 如果本次
\G全局匹配成功,位移指针自然会后移 - 如果本次
\G全局匹配失败,且没有加上c修饰符,那么位移指针将重置 - 如果本次
\G全局匹配失败,且加上了c修饰符,那么位移指针将卡在那不动
例如:
$txt="1234ab56";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\G\d/g;     # 强制从位移4开始匹配,无法匹配字母a,但又不允许跳过
                     # 所以本次\G全局匹配失败,由于没有修饰符c,指针重置
print "matched $&: ",pos $txt,"\n";
$txt =~ /\G\d/g;     # 指针回到0,强制从0处开始匹配,数值1能匹配成功
print "matched $&: ",pos $txt,"\n";
以下是输出内容:
matched 12: 2
matched 34: 4
matched 34:
matched 1: 1
如果将上面第三个匹配语句加上修饰符c,甚至后面的语句也都加上 \G 和c修饰
符,那么位移指针将卡在那个位置:
$txt="1234ab56";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\d\d/g;
print "matched $&: ",pos $txt,"\n";
$txt =~ /\G\d/gc;        # 匹配失败,指针卡在原地
print "matched $&: ",pos $txt,"\n";
$txt =~ /\G\d/gc;        # 匹配失败,指针继续卡在原地
print "matched $&: ",pos $txt,"\n";
$txt =~ /\G\d/gc;        # 匹配失败,指针继续卡在原地
print "matched $&: ",pos $txt,"\n";
以下是输出结果:
matched 12: 2
matched 34: 4
matched 34: 4
matched 34: 4
matched 34: 4
一般来说,全局匹配都会用循环去多次迭代,和上面一次一次列出匹配表达式不
一样。所以,下面使用while循环的例子来对 \G 和c修饰符稍作解释,其实理
解了上面的内容,在循环中使用 \G 和c修饰符也一样很容易理解。
$txt="1234ab56";
while($txt =~ m/\G\d\d/gc){
    print "matched: $&, ",pos $txt,"\n";
}
执行结果:
matched: 12, 2
matched: 34, 4
当第三轮循环匹配到a字母的时候,由于使用了 \G ,导致匹配失败,结束循
环。
上面使用c与否是无关紧要的,但如果这个while循环的后面后还有对 $txt 的
匹配,那么使用c修饰符与否就有关系了。例如下面两段程序,返回结果不一样:
$txt="1234ab56";
while($txt =~ m/\G\d\d/gc){   # 使用c修饰符
    print "matched: $&, ",pos $txt,"\n";
}

$txt =~ m/\G\d\d/gc;
print "matched: $&, ",pos $txt,"\n";
和
$txt="1234ab56";
while($txt =~ m/\G\d\d/g){   # 不使用c修饰符
    print "matched: $&, ",pos $txt,"\n";
}

$txt =~ m/\G\d\d/gc;
print "matched: $&, ",pos $txt,"\n";
m修饰符:多行匹配模式
正则表达式一般都只用来匹配单行数据,但有时候却需要一次性匹配多行。比如 匹配跨行单词、匹配跨行词组,匹配跨行的对称分隔符(如一对括号)。
使用m修饰符可以开启多行匹配模式。
例如:
$txt="ab\ncd";
$txt =~ /a.*\nc/m;
print "===match start===\n$&\n===match end===\n";
执行,将输出:
===match start===
ab
c
===match end===
关于多行匹配,需要注意的是元字符=.=默认情况下无法匹配换行符。可以使用
[\d\D] 代替点,也可以开启s修饰符使得 . 能匹配换行符。
例如,下面两个匹配输出的结果和上面是一致的。
$txt="ab\ncd";
$txt =~ /a.*c/ms;
print "===match start===\n$&\n===match end===\n";

$txt="ab\ncd";
$txt =~ /a[\d\D]*c/m;
print "===match start===\n$&\n===match end===\n";
s修饰符
默认情况下, . 元字符是不能匹配换行符 \n 的,开启了s修饰符功能后,
可以让 . 匹配换行符。正如刚才的那个例子:
$txt="ab\ncd";
$txt =~ /a.*c/m;        # 匹配失败
print "===match start===\n$&\n===match end===\n";

$txt="ab\ncd";
$txt =~ /a.*c/ms;       # 匹配成功
print "===match start===\n$&\n===match end===\n";
x修饰符
正则表达式最为人所抱怨的就是它的可读性极差,无论你的正则能力有多强,看 着一大堆乱七八糟的符号组合在一起,都得一个符号一个符号地从左向右读。
万幸,perl正则支持表达式的分隔,甚至支持注释,只需加上x修饰符即可。这
时候正则表达式中出现的所有空白符号都不会当作正则的匹配对象,而是直接被
忽略。如果想要匹配空白符号,可以使用 \s 表示,或者将空格使用
\Q...\E 包围。
例如,以下4个匹配操作是完全等价的。
$ans="cat sheep tiger";
$ans =~ /(\w) *(\w) *(\w)/;       # 正常情况下的匹配表达式
$ans =~ /(\w)\s*   (\w)\s*   (\w)/x;
$ans = ~ /
        (\w)\s*      # 可以加上本行注释:匹配第一个单词
        (\w)\s*      # 可以加上本行注释:匹配第二个单词
        (\w)         # 可以加上本行注释:匹配第三个单词
        /x;
$ans =~ /
         (\w)\Q \E   # \Q \E强制将中间的空格当作字面符号被匹配
         (\w)\Q \E
         (\w)
        /x;
对于稍微复杂一些的正则表达式,常常都会使用x修饰符来增强其可读性,最重 要的是加上注释。这一点真的非常人性化。
p修饰符
前面说过,通过3个特殊变量 $` 、 $& 和 $' 可以保存匹配内容之前的
内容,匹配内容以及匹配内容之后的内容。但是,只要使用了这3个变量中的任
何一个,后面的所有分组效率都会降低。perl提供了一个p修饰符,能实现完全
相同的功能:
${^PREMATCH}    <=>   $`
${^MATCH}       <=>   $&
${^POSTMATCH}   <=>   $'
一个例子即可描述:
$ans="cat sheep tiger";
$ans =~ /sheep/p;
print "${^PREMATCH}\n";     # 输出"cat "
print "${^MATCH}\n";        # 输出"sheep"
print "${^POSTMATCH}\n";    # 输出" tiger"
o修饰符
在较老的perl版本中,如果使用同一个正则表达式做多次匹配,正则引擎将只多 次编译正则表达式。很多时候正则表达式并不会改变,比如循环匹配文件中的行, 这样的多次编译导致性能下降很明显,于是可以使用o修饰符让正则引擎对同一 个正则表达式不重复编译。
在perl5.6中,默认情况下对同一正则表达式只编译一次,但同样可以指定o修饰 符,使得即使正则表达式变化了也不要重新编译。
一般情况下,可以无视这个修饰符。
范围模式匹配修饰符(?imsx-imsx:pattern)
前文介绍的修饰符 adluoimsxpngc 都是放在 m//{FLAG} 的flag处的,放在
这个位置会对整个正则表达式产生影响,所以它的作用范围有点广。
例如 m/pattern1 pattern2/i 的i修饰符会影响pattern1和pattern2。
perl允许我们定义只在一定范围内生效的修饰符,方式是 (?imsx:pattern)
或 (?-imsx:pattern) 或 (?imsx-imsx:pattern) ,其中加上 - 表示去
除这个修饰符的影响。这里只列出了imsx,因为这几个最常用,其他的修饰符也
一样有效。
例如,对于待匹配字符串”Hello world gaoxiaofang”,使用以下几种模式去 匹配的话:
/(?i:hello) world/
表示匹配hello时,可忽略大小写,但匹配world时仍然区分大小写。所以匹配成功
/(?ims:hello.)world/
表示可以跨行匹配helloworld,也可以匹配单行的hellosworld,且hello部分忽 略大小写。所以匹配成功
/(?i:hello (?-i:world) gaoxiaoFANG)/
表示在第二个括号之前,可用忽略大小写进行匹配,但因为第二个括号里指明了 去除i的影响,所以对world的匹配会区分大小写,但是对gaoxiaofang部分的匹 配又不区分大小写。所以匹配成功
/(?i:hello (?-i:world) gaoxiao)FANG/
和前面的类似,但是将”FANG”放到了括号外,意味着这部分要区分大小写。所 以匹配失败
perl支持的反斜线序列
1.锚定类的反斜线序列
所谓锚定,是指它匹配的是位置,而非字符,比如锚定行首的意思是匹配第一个 字母前的空字符。也就是很多人说的”零宽断言(zero-width assertions)“。
\b:匹配单词边界处的空字符\B:匹配非单词边界处的空字符\<:匹配单词开头处的空字符\>:匹配单词结尾处的空字\A:匹配绝对行首,换句话说,就是输入内容的开头\z:匹配绝对行尾,换句话说,就是输入内容的绝对尾部\Z:匹配绝对行尾或绝对行尾换行符前的位置,换句话说,就是输入内容的尾部\G:强制从位移指针处进行匹配,详细内容见 "g和c修饰符以及\G"
主要解释下 \A \z \Z ,其它的属于基础正则的内容,不多做解释了。
\A \z \Z 和 ^ $ 的区别主要体现在多行模式下。在多行模式下:
First Line\nSecond line\n

(^匹配任意行首)First Line($匹配任意行尾)\n(^匹配任意行首)Second line($匹配任意行尾)\n


(\A匹配整个输入的绝对开头)First Line\nSecond line(\Z匹配整个输入的尾部,或绝对尾部换行符的前面)\n(\z匹配整个输入的绝对尾部)
$txt = "abcd\nABCD\n";
$txt1 = "abcd\nABCD";

$txt =~ /^ABC*/;   # 无法匹配
$txt =~ /^ABC*/m;  # 匹配

$txt =~ /\Aabc/;   # 匹配
$txt =~ /\Aabc/m;  # 匹配
$txt =~ /\AABC/m;  # 无法匹配

$txt =~ /cd\n$/m;  # 不匹配
$txt =~ /cd$\n/m;  # 不匹配
$txt =~ /cd$/m;    # 匹配

$txt =~ /CD\Z\n/m  # 匹配
$txt =~ /CD\Z\n\Z/m; # 匹配
$txt =~ /CD\n\z/m; # 匹配

$txt1 =~ /CD\Z/m;  # 匹配
$txt1 =~ /CD\z/m;  # 匹配

# perl -e '$txt = "abcd\nABCD\n"; $txt =~ /CD\Z/m; print "$&"  # 匹配'
CD
从上面的 $ 匹配示例可知, $ 代表的行尾,其实它在有换行符的时候匹
配”\n",而不是"\n“的前、后,在没有换行符的时候,匹配行尾。
2.字符匹配反斜线序列
当然,除了以下这几种,还有 \v \V \h \H \R \p \c \X ,这些基本不会用上,所以都不会在本文解释。
- \w:匹配单词构成部分,等价于 [_[:alnum:]]
- \W:匹配非单词构成部分,等价于 [^_[:alnum:]]
- \s:匹配空白字符,等价于 [[:space:]]
- \S:匹配非空白字符,等价于 [^[:space:]]
- \d:匹配数字,等价于 [0-9]
- \D:匹配非数字,等价于[^0-9]
- \N:不匹配换行符,等价于[^\n]。但 \N{NAME}有特殊意义,表示匹配已命名(名为NAME)的unicode字符序列,本文不介绍该特殊用法
由于元字符=.=默认无法匹配换行符,所以需要匹配换行符的时候,可以使用特
殊组合 [\d\D] 或者 (\n|\N) 来替换 . ,换句话说,如果想匹配任意长
度的任意字符,可以换成 [\d\D]* 或者 (\n|\N)* ,当然,前提是必须支
持这3个反斜线序列。
之所以不用 [\n\N] 替代元字符 . ,是因为 \N 有特殊意义,不能随意接符号和字母。
3.分组引用的反斜线序列
\1:反向引用,其中1可以替换为任意一个正整数,即使超出9,例如\111表示匹配第111个分组\g1或\g{1}:也是反向引用,只不过这种写法可以避免歧义,例如\g{1}11表示匹配第一个分组内容后两个数字1\g{-1}:还可以使用负数,表示距离\g左边的分组号,也就是相对距 离。例如(abc)([a-z])\g{-1}中的\g引用的是[a-z],如果-1换 成-2,则引用的abc\g{name}:引用已命名的分组(命名捕获),其中name为分组的名称\k<name>:同上,引用已命名的分组(命名捕获),其中name为分组的名称\K:不要将\K左边的内容放进$&。换句话说,\K左边的内容 即使匹配成功了,也会重置匹配的位置
\1 表示引用第一个分组, \11 表示引用第11个分组,在基础正则中,是不
支持引用超出9个分组的,但显然perl会将 \11 的第二个1解析为引用,以便
能引用更多分组。
同理 \g1 和 \g11 ,只是使用 \g 引用的方式可以加上大括号使引用变
得更安全,更易读,且 \g 可以使用负数来表示从右向左相对引用。这样在
\g{-2} 的左边添加新的分组括号时,无须修改引用表达式。
此处暂时还没介绍到命名分组,所以 \g{name} 和 \k<name> 留在后面再介绍。
\K 表示强制中断前面已完成的匹配。例如 "abc22ABC" =~ /abc\K2.*/; ,
虽然abc三个字母也被匹配,如果没有 \K ,这3个字母将放进 $& 中,但是
\K 使得匹配完abc后立即切断前面的匹配,也就是从c字母后面开始重新匹配,
所以这里匹配的结果是22ABC。
再例如, "abc123abcfoo"=~ /(abc)123\K\g1foo/; ,它匹配到123后被切断,
但是分组引用还可以继续引用,所以匹配的结果是”abcfoo”。
贪婪匹配、非贪婪匹配、占有优先匹配
在基础正则中,那些能匹配多次的量词都会匹配最长内容。这种尽量多匹配的行 为称为”贪婪匹配”(greedy match)。
例如字符串”aa1122ccbb”,用正则表达式 a.*c 去匹配这个字符串,其中的
.* 将直接从第二个字母a开始匹配到最结尾的b,因为从第二个字母a开始到
最后一个字母b都符合 .* 的匹配模式。再然后,去匹配字母c,但因为已经
把所有字母匹配完了,只能回退一个字母一个字母地释放,每释放一个就匹配
一次字母c,发现回退释放到倒数第三个字母就能满足匹配要求,于是这里的
.* 最终匹配的内容是”a1122cc”。
上面涉及到回溯的概念,也就是将那些已经被量词匹配的内容回退释放。
上面描述的是贪婪匹配行为,还有非贪婪匹配、占有优先匹配,以下简单描述下 他们的意义:
- 非贪婪匹配:(lazy match,reluctant)尽可能少地匹配,也叫做懒惰匹配
- 占有优先匹配:(possessive)占有优先和固化分组是相同的,只要占有了就不 再交换,不允许进行回溯。相关内容见后文”固化分组”
有必要搞清楚这几种匹配模式在匹配机制上的区别:
- 贪婪匹配:对于那些量词,将一次性从左到右匹配到最大长度,然后再往回回溯释放
- 非贪婪匹配:对于那些量词,将从左向右逐字符匹配最短长度,然后直接结束 这次的量词匹配行为
- 占有优先匹配:按照贪婪模式匹配,匹配后内容就锁住,不进行回溯(后文固 化分组有具体示例)
除了上面描述的 * 量词会进行贪婪匹配,其他所有能进行多次匹配的量词可
以选择贪婪匹配模式、非贪婪匹配模式和占有优先匹配模式,只需选择对应的量
词元字符即可。如下:
                        (量词后加上?)             (量词后加上+)
  贪婪匹配量词           非贪婪匹配量词           占有优先匹配量词
-----------------------------------------------------------------
      *                    *?                         *+
      ?                    ??                         ?+
      +                    +?                         ++
      {M,}                 {M,}?                      {M,}+
      {M,N}                {M,N}?                     {M,N}+
      {N}                  {N}?                       {N}+
几点需要说明:
- 非贪婪匹配时的
{M,}?和{M,N}?,它们是等价的,因为最多只匹配M次 - 在perl中不支持
{,N}的模式,所以也没有对应的非贪婪和占有优先匹配模式 - 关于
{N}这个量词,由于是精确匹配N次,所以贪婪与否对最终结果无关紧 要,但是却影响匹配时的行为:贪婪匹配最长,需要回溯,非贪婪匹配最短, 不回溯,占有优先匹配最长不回溯。
看以下示例即可理解贪婪和非贪婪匹配的行为:
$str="abc123abc1234";

# greedy match
if( $str =~ /(a\w*3)/){
    print "$&\n";       # abc123abc123
}

# lazy match
if( $str =~ /(a\w*?3)/){
    print "$&\n";      # abc123
}
以下是占有优先匹配模式的示例:
$str="abc123abc1234";

if( $str =~ /a\w*+/){     # 成功
        print "possessive1: $&\n"; # abc123abc1234
}
if( $str =~ /a\w*+3/){    # 失败
        print "possesive2: $&\n";
}
所以,在使用占有优先匹配模式时,它后面不应该跟其他表达式,例如 a*+x 永
远匹配不了东西。绝大多数时候都是不会回溯的。但是少数情况下,它并非强制
锁住回溯,这个和正则引擎匹配原理有关,本文不多做解释。
另外,固化分组和占有优先并不完全等价,它们只是匹配行为相同:匹配后不回 溯。具体可对比后文对应内容。
perl的分组捕获和分组引用
- 分组的基本应用
在基础正则中,使用括号可以对匹配的内容进行分组,这种行为称为分组捕获。 捕获后可以通过
\1这种反向引用方式去引用(访问)保存在分组中的匹配结果。例如:
"abc11ddabc11" =~ /([a-z]*)([0-9]*)dd\1\2/;
在perl中,还可以使用=\gN=的方式来反向引用分组,这个在上一节”反斜线序 列”中已经解释过了。例如,以下是和上面等价的几种写法:
"abc11ddabc11" =~ /([a-z]*)([0-9]*)dd\g1\g2/;
"abc11ddabc11" =~ /([a-z]*)([0-9]*)dd\g{1}\g{2}/;
"abc11ddabc11" =~ /([a-z]*)([0-9]*)dd\g{-2}\g{-1}/;
perl还会把分组的内容放进perl自带的特殊变量
$1,$2,...,$N中,它们和\1,\2,...\N在*匹配成功时*的结果上没有区别,但是\N这种类型的反向 引用只在正则匹配中有效,正则匹配结束后就消亡了,而$N因为是perl的变 量,即使正则已经退出匹配,也依然可以引用。所以,我们可以使用$N的方 式来输出分组匹配的结果:"abc11ddabc11" =~ /([a-z]*)([0-9]*)dd\1\2/; print "first group \\1: $1\n"; #abc print "second group \\2: $2\n"; #11
有两点需要注意:
- 这些分组可能捕获到的是空值(比如那些允许匹配0次的量词),但是整个匹配 是成功的。这时候引用分组时,得到的结果也将是空值
- 当分组匹配失败的时候,
\1会在识别括号的时候重置,而$1仍保存上一次分 组成功的值
第一点,示例可知:
"abcde" =~ /([0-9]*)de/;
print "null group: $1\n";
第二点,从机制上去分析。
\1是每个正则匹配都相互独立的,而$1则保 存分组捕获成功的值,即使这次值是上次捕获的。正则匹配的操作如果在列表上下文,则保存各个分组捕获的内容。所以,出于方 便,可以通过下面的方式直接将分组捕获的结果赋值给指定变量:
$date = "2018-11-22";

($year,$mon,$day) = ($date =~ /(\d{4})-(\d{2})-(\d{2})/);
这里稍微解释下正则匹配关于分组捕获的匹配过程:
例如,匹配表达式
"12abc22abc" =~ /\d(abc)\d\d\1/;,当正则引擎去匹配 数据时:- 首先匹配第一个数字1,发现符合
\d,于是继续用(abc)去匹配字符串, 因为发现了是分组括号,于是会将第二个字符2放进分组,发现不匹配字母a, 于是匹配失败,丢弃这个分组中的内容。 - 正则引擎继续向后匹配数值2,发现符合
\d,于是用(abc)去匹配字 符串,接着会将第三个字符a放进分组,发现能匹配,继续匹配字符串中的b、 c发现都能匹配,于是分组捕获完成,将其赋值给$1,之后就能用\1和$1去引用这个分组的内容。 - 后面继续去匹配
\d\d\1,直到匹配结束。
当然,具体匹配的过程不会真的这么简单,它会有一些优化匹配方式,以上只是 用逻辑去描述匹配的过程。
- perl中更强大的分组捕获
在perl中,支持的分组捕获更强大、更完整,它除了支持普通分组(也就是直接 用括号的分组),还支持:
- 命名捕获
(?<NAME>...):捕获后放进一个已分配好名称(即NAME)的分组中, 以后可以使用这个名称来引用这个分组,如\g{NAME}引用 - 匿名捕获
(?:...):仅分组,不捕获,所以后面无法再引用这个捕获 - 固化分组
(?>...):一匹配成功就永不交回内容(用回溯的想法理解很容易)
匿名捕获
匿名捕获是指仅分组,不捕获。因为不捕获,所以无法使用反向引用,也不会将 分组结果赋值给
$1这种特殊变量。虽然有了分组捕获功能,就可以实现任何需求,但有时候可以让这种行为变得更 人性化,减少维护力度。
例如字符串”xiaofang or xiaoming”,使用模式
/(\w+) or (\w+)/去捕获, 用$1和$2分别引用or左右两个单词:$str = "xiaofang or xiaoming"; if ($str =~ /(\w+) or (\w+)/){ print "name1: $1, name2: $2\n"; #name1: xiaofang, name2: xiaoming }
但如果需求是中间的关系or也可以换成and,为了同时满足and和or两种需求,使 用模式
/(\w+) (and|or) (\w+)/去匹配,但是这时引用的序号就得由$2变为$3:$str = "xiaofang or xiaoming"; if ($str =~ /(\w+) (or|and) (\w+)/){ print "name1: $1, name2: $3\n"; }
如果使用匿名捕获,对and和or这样无关紧要,却有可能改变匹配行为的内容, 可以将其放进一个无关的分组中。这样不会对原有的其余正则表达式产生任何影 响:
$str = "xiaofang or xiaoming";
if ($str =~ /(\w+) (?:or|and) (\w+)/){
    print "name1: $1, name2: $2\n";
}
注意上面仍然使用
$2引用第三个括号。同样,如果要在正则内部使用反向引用,也一样使用
\2来引用第三个括号。另外,在前文还介绍过一个
n修饰符,它也表示非捕获仅分组行为。但它只 对普通分组有效,对命名分组无效。且因为它是修饰符,它会使所有的普通分组 都变成非捕获模式。$str = "xiaofang or xiaoming"; if ($str =~ /(\w+) (or|and) (\w+)/n){ print "name1: $1, name2: $2\n"; }
由于上面开启了n修饰符,使得3个普通分组括号都变成非捕获仅分组行为,所以
\1和$1都无法使用。除非正则中使用了命名分组。命名捕获
命名捕获是指将捕获到的内容放进分组,这个分组是有名称的分组,所以后面可 以使用分组名去引用已捕获进这个分组的内容。除此之外,和普通分组并无区别。
当要进行命名捕获时,使用
(?<NAME>)的方式替代以前的分组括号()即 可。例如,要匹配abc并将其分组,以前普通分组的方式是(abc),如果将其 放进命名为name1的分组中:(?<name1>abc)。当使用命名捕获的时候,要在正则内部引用这个命名捕获,除了可以使用序号类 的绝对引用(如
\1或\g1或\g{1}),还可以使用以下任意一种按名称 引用方式:\g{NAME}\k{NAME}\k<NAME>\k'NAME'
如果要在正则外部引用这个命名捕获,除了可以使用序号类的绝对应用(如
$1),还可以使用=$+{NAME}=的方式。实际上,后一种引用方式的本质是perl将命名捕获的内容放进了一个名为
%+的特殊hash类型中,所以可以使用$+{NAME}的方式引用,如果你不知道这一 点,那就无视与此相关的内容即可,不过都很简单,一看就懂。例如:
$str = "ma xiaofang or ma xiaoming";
if ($str =~ /
            (?<firstname>\w+)\s  # firstname -> ma
            (?<name1>\w+)\s      # name1 -> xiaofang
            (?:or|and)\s      # group only, no capture
            \g1\s                # \g1 -> ma
            (?<name2>\w+)        # name2 -> xiaoming
            /x){
    print "$1\n";
    print "$2\n";
    print "$3\n";
    # 或者指定名称来引用
    print "$+{firstname}\n$+{name1}\n$+{name2}\n";
}
其中上述代码中的
\g1还可以替换为\1、\g{firstname}、\k{firstname}或\k<firstname>。通过使用命名捕获,可以无视序号,直接使用名称即可准确引用。
固化分组
首先 固化分组不是一种分组,所以无法去引用它 。它和”占有优先”匹配模 式(贪婪匹配、惰性匹配、占有优先匹配三种匹配模式,见后文)是等价的除了这 两种称呼,在不同的书、不同的语言里还有一种称呼:原子匹配。
它的表示形式类似于分组
(?>),所以有些地方将其称呼为”固化分组”。再 次说明,固化分组不是分组,无法进行引用。如果非要将其看作是分组,可以将 其理解为被限定的匿名分组:不捕获,只分组。- 按照”占有优先”的字面意义来理解比较容易:只要匹配成功了,就绝不回 溯。
- 如果按照固化分组的概念来理解,就是将匹配成功的内容放进分组后,将其 固定,不允许进行回溯。但是需要注意,*这里的不回溯是放进分组中的内容 不会回溯给分组外面,而分组内部的内容是可以回溯的*。
如果不知道什么是回溯,看完下面的例子就明白。
例如”hello world”可以被
hel.* world成功匹配,但不能被hel(?>.*) world匹配。因为正常情况下,.*匹配到所有内容,然后往回释放已匹配 的内容直到释放完空格为止,这种往回释放字符的行为在正则术语中称为”回 溯”。而固化分组后,.*已匹配后面所有内容,这些内容一经匹配绝不交回, 即无法回溯。但是,如果正则表达式是
hel(?>.* world),即将原来分组外面的内容放进 了分组内部,这时在分组内部是会回溯的,也就是说能匹配”hello world”。$str="ma long.xi gao xiaofang"; if($str =~ /ma (?>long.*)/){ # 成功 print "matched\n"; } if($str =~ /ma (?>long.*)gao/){ # 失败 print "matched\n"; } if($str =~ /ma (?>long.*gao)/){ # 成功 print "matched\n"; } if($str =~ /ma (?>long.*g)ao/){ # 成功 print "matched\n"; }
固化分组看上去挺简单的,此处也仅介绍了它最简单的形式。但实际上固化分组 很复杂,它涉及了非常复杂的正则引擎匹配原理和回溯机制。如果有兴趣,可以 阅读《精通正则表达式》一书的第四章。
- 命名捕获
环视锚定(断言)
"环视"锚定,即lookaround anchor,也称为”零宽断言”,它表示匹配的是位 置,不是字符。
- (?=...) 表示从左向右的顺序环视。例如 (?=\d) 表示当前字符的右边是一个数字时就满足条件
- (?!...) 表示顺序环视的取反。如 (?!\d) 表示当前字符的右边不是一个数字时就满足条件
- (?<=...) 表示从右向左的逆序环视。例如 (?<=\d) 表示当前字符的左边是一个数字时就满足条件
- (?<!)...  表示逆序环视的取反。如 (?<!\d) 表示当前字符的左边不是一个数字时就满足条件
关于”环视”锚定,最需要注意的一点是匹配的结果不占用任何字符,它仅仅只是锚定位置。所以断言只是个条件。
例如”your name is xiaoming MA”和”your name is longfei MA”。使用
(?=xiaoming) 将能锚定第一个句子中单词”xiaoming”前面的空字符,但它
的匹配结果是”xiaoming”前的空白字符,所以 (?=xiaoming)xiao 才能代
表”xiao”这几个字符串,所以仅对于此处的两个句子, xiao(?=ming) 和
(?=xiaoming)xiao 是等价的。
一般为了方便理解,在顺序环视的时候会将匹配内容放在锚定括号的左边(如
xiao(?=xiaoming) ),在逆序环视的时候会将匹配的内容放在锚定括号的右边
(如 (?<=xiao)ming )。
另外,无论是哪种锚定,都是从左向右匹配再做回溯的(假设允许回溯),即使是 逆序环视。
例如:
$str="abc123abcc12c34";

# 顺序环视
$str =~ /a.*c(?=\d)/;     # abc123abcc12c
print "$&\n";

# 顺序否定环视
$str =~ /a.*c(?!\d)/;     # abc123abc
print "$&\n";

# 逆序环视,这里能逆序匹配成功,靠的是锚定括号后面的c
$str =~ /a.*(?<=\d)c/;    # abc123abcc12c
print "$&\n";

# 逆序否定环视
$str =~ /a.*(?<!\d)c/;    # abc123abcc
print "$&\n";
逆序环视的表达式必须只能表示固定长度的字符串。例如 (?<=word) 或
(?<=word|word) 可以,但 (?<=word?) 不可以,因为 ? 匹配0或1长度,
长度不定,它无法对左边是word还是wordx做正确判断。
$str="hello worlds Gaoxiaofang";
$str =~ /he.*(?<=worlds?) Gao/;         # 报错
$str =~ /he.*(?<=worlds|world) Gao/;    # 报错
在PCRE中,这种变长的逆序环视锚定可重写为 (?<=word|words) ,但perl中
不允许,因为perl严格要求长度必须固定。
\Q…\E
perl中的 \Q...\E 用来强制包围一段字符,使得里面的正则符号都当做普通
字符,不会有特殊意义,它是一种非常强的引用。但注意,它无法强制变量的替
换。
例如:
$sub="world";
$str="hello worlds gaoxiaofang";
$str =~ /\Q$sub\E/;  # $sub会替换,所以匹配成功world
$str =~ /\Q$sub.\E/; # 元字符"."被当做普通的字符,所以无法匹配
qr//创建正则对象
因为可以在正则模式中使用变量替换,所以我们可以将正则中的一部分表达式事 先保存在变量中。例如:
$str="hello worlds gaoxiaofang";
$pattern="w.*d";
$str =~ /$pattern/;
print "$&\n";
但是,这样缺陷很大,在保存正则表达式的变量中存放的特殊字符要防止有特殊
意义。例如,当使用 m// 的方式做匹配分隔符时,不能在变量中保存 / ,
除非转义。
perl提供了 qr/pattern/ 的功能,它把pattern部分构建成一个正则表达式对
象,然后就可以在正则表达式中直接引用这个对象,更方便的是可以将这个对象
保存到变量中,通过引用变量的方式来引用这个已保存好的正则对象。
$str="hello worlds gaoxiaofang";

# 直接作为正则表达式
$str =~ qr/w.*d/;
print "$&\n"; #world

# 保存为变量,再作为正则表达式
$pattern=qr/w.*d/;
$str =~ $pattern;    # (1)
$str =~ /$pattern/;  # (2)
print "$&\n"; #world

# 保存为变量,作为正则表达式的一部分
$pattern=qr/w.*d/;
$str =~ /hel.* $pattern/;
print "$&\n"; #hello world
还允许为这个正则对象设置修饰符,比如忽略大小写的匹配修饰符为i,这样在 真正匹配的时候,就只有这一部分正则对象会忽略大小写,其余部分仍然区分大 小写。
$str="HELLO wORLDs gaoxiaofang";

$pattern=qr/w.*d/i;         # 忽略大小写

$str =~ /HEL.* $pattern/;   # 匹配成功,$pattern部分忽略大小写
$str =~ /hel.* $pattern/;   # 匹配失败
$str =~ /hel.* $pattern/i;  # 匹配成功,所有都忽略大小写
引擎选项
- 默认模式:将整个测试字符串看做一个一行的大字符串,.不能代表\n
- 单行模式:将整个测试字符串看做一个一行的大字符串,.可以匹配\n
- 多行模式:终于可以把一行大字符串用\n分割成多行,^指的是行首,$行尾,.行为不变
范例
so very very sorry
vys ray

v.*y 匹配,整个看做一行,从very 到sorry,遇到\n不能突破,后面再匹配vys ray
so =very very sorry=
=vys ray=

v.*y 单行模式匹配,可以突破\n
=very very sooryvys ray=

^v.*y 单行模式匹配。 空
^v.*y 默认匹配。 空

v.*y 多行模式匹配
so =very very sorry=
=vys ray=

^v.*y 多行模式匹配
=vys ray=

^v.*y 单行和多行模式匹配
=vys ray=

^v.*y$ 单行模式匹配。 空
匹配范例
java业务日志
2025-05-19 11:09:47.441  INFO 8 --- [ XNIO-2 task-36] c.r.a.s.a.impl.SeaAppVersionServiceImpl  82 : APP_VERSION_CACHE 执行耗时=5ms
2025-05-19 11:02:41.120  INFO 8 --- [nio-1050-exec-2] .r.m.w.s.s.i.UserSignInRecordServiceImpl 162 : signDateasdads:true
2026-01-12 17:08:35.904  INFO 8 --- [ XNIO-2 task-15] com.rl.gateway.filter.LogFilter          : doFilter==============end================

#多行合并
^\d+-\d+-\d+.*

#日志格式化
(\S+ \S+[\d.]+)\s+(\S+)\s+(\d{1,2})\s+---\s+\[\s{0,}(.*)?\]\s+(\S+)\s+(\d{1,4})?\s+:\s+(.*)

#注意多行匹配问题。不能这样写
#(\S+ \S+[\d.]+)\s+(\S+)\s+(\d{1,2})\s+---\s+\[\s{0,}([\s\S]+)?\]\s+(\S+)\s+(\d{1,4})\s+:\s+(.*)

#匹配组命名
time
level
pid
thread-name
logger
line
msg

文本处理三剑客
- grep 命令主要对文本的(正则表达式)行基于模式进行过滤
- sed:stream editor,文本编辑工具
- awk:Linux上的实现gawk,文本报告生成器
文本处理三剑客之 grep
grep: Global search REgular expression and Print out the line
作用:文本搜索工具,根据用户指定的“模式”对目标文本逐行进行匹配检查; 打印匹配到的行
模式:由正则表达式字符及文本字符所编写的过滤条件
格式: grep [OPTIONS] PATTERN [FILE…]
常见选项:
--color=auto 对匹配到的文本着色显示
-m # 匹配#次后停止
-v 显示不被pattern匹配到的行
-i 忽略字符大小写
-n 显示匹配的行号
-c 统计匹配的行数
-l : 只显示匹配到的文件名
-o 仅显示匹配到的字符串
-o -b : 显示匹配的位置
-q 静默模式,不输出任何信息
-A # after, 后#行
-B # before, 前#行
-C # context, 前后各#行
-e 实现多个选项间的逻辑or关系,如:grep –e ‘cat ’ -e ‘dog’ file
-w 匹配整个单词
-E 使用ERE,相当于egrep
-F 不支持正则表达式,相当于fgrep
-f file 根据模式文件处理
-r 递归目录,但不处理软链接
-R 递归目录,但处理软链接
-s 如果过滤到不是文本文件会报错,加此选项不显示错误信息

--line-buffered  每输出一行,就刷新一次
-P : 可以让grep使用perl的正则表达式语法. 匹配中文 grep -P '[\x{4e00}-\x{9f5a}]' xx.log
范例:过滤目录,查找隐藏目录用 . 点号,* 星号无法找到隐藏文件
grep --exclude-dir=".git" --exclude-dir=".svn" -rns test .
范例:
grep root /etc/passwd grep "USER" /etc/passwd grep 'USER' /etc/passwd grep whoami /etc/passwd
范例:取两个文件的相同行
[root@centos8 ~]#cat /data/f1.txt a b 1 c [root@centos8 ~]#cat /data/f2.txt b e f c 1 2 [root@centos8 ~]#grep -f /data/f1.txt /data/f2.txt b c 1 #取文件的共同行 [root@centos8 data]#cat test1.txt test2.txt | sort |uniq -d 1 b c
范例:
df | grep '^/dev/sd' |tr -s ' ' %|cut -d% -f5|sort -n|tail -1
范例:
[root@centos8 ~]#ss -nt | grep "^ESTAB" |tr -s ' ' : |cut -d: -f6|sort |uniq - c|sort -nr|head -n3 3 10.0.0.1 1 172.16.4.100 1 172.16.31.188
范例:
[root@centos8 ~]#grep -v "^#" /etc/profile | grep -v '^$' [root@centos8 ~]#grep -v "^#\|^$" /etc/profile [root@centos8 ~]#grep -v "^\(#\|$\)" /etc/profile [root@centos8 ~]#grep -Ev "^(#|$)" /etc/profile [root@centos8 ~]#egrep -v "^(#|$)" /etc/profile [root@centos6 ~]#egrep -v '^(#|$)' /etc/httpd/conf/httpd.conf
范例:
[root@centos8 ~]#grep -o 'r..t' /etc/passwd
root
root
root
root
r/ft
rypt
范例:
[root@centos8 ~]#ifconfig | grep -E '[0-9]{1,3}.[0-9]{1,3}.[0-9]{1,3}.[0-9]{1,3}' inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 inet 172.16.0.123 netmask 255.255.0.0 broadcast 172.16.255.255 inet6 fe80::c11e:4792:7e77:12a4 prefixlen 64 scopeid 0x20<link> inet 127.0.0.1 netmask 255.0.0.0 [root@centos8 ~]#ifconfig | grep -E '([0-9]{1,3}.){3}[0-9]{1,3}' inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 inet 172.16.0.123 netmask 255.255.0.0 broadcast 172.16.255.255 inet6 fe80::c11e:4792:7e77:12a4 prefixlen 64 scopeid 0x20<link> inet 127.0.0.1 netmask 255.0.0.0 [root@centos8 ~]#ifconfig eth0 | grep -Eo '([0-9]{1,3}\.){3}[0-9]{1,3}'|head -1 10.0.0.8 [root@centos8 ~]#cat regex.txt ([0-9]{1,3}\.){3}[0-9]{1,3} [root@centos8 ~]#ifconfig | grep -oEf regex.txt 10.0.0.8 255.255.255.0 10.0.0.255 127.0.0.1 255.0.0.0
范例:
[root@centos8 ~]#grep -E 'root|bash' /etc/passwd root:x:0:0:root:/root:/bin/bash operator:x:11:0:operator:/root:/sbin/nologin wang:x:1000:1000:wang:/home/wang:/bin/bash cici:x:1001:1001::/home/cici:/bin/bash xiaoming:x:1002:1002::/home/xiaoming:/bin/bash roob:x:1003:1003::/home/roob:/bin/bash [root@centos8 ~]#grep -e 'root' -e 'bash' /etc/passwd root:x:0:0:root:/root:/bin/bash operator:x:11:0:operator:/root:/sbin/nologin wang:x:1000:1000:wang:/home/wang:/bin/bash cici:x:1001:1001::/home/cici:/bin/bash xiaoming:x:1002:1002::/home/xiaoming:/b
范例:
[root@centos8 ~]#grep -w root /etc/passwd
root:x:0:0:root:/root:/bin/bash
operator:x:11:0:operator:/root:/sbin/nologin
[root@centos8 ~]#grep '\<root\>' /etc/passwd
root:x:0:0:root:/root:/bin/bash
operator:x:11:0:operator:/root:/sbin/nologin
范例:
[root@centos8 ~]#grep "^\(.*\)\>.*\<\1$" /etc/passwd sync:x:5:0:sync:/sbin:/bin/sync shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown halt:x:7:0:halt:/sbin:/sbin/halt bash:x:1008:1008::/home/bash:/bin/bash nologin:x:1011:1011::/home/nologin:/sbin/nologin [root@centos8 ~]#grep -E "^(.*)\>.*\<\1$" /etc/passwd sync:x:5:0:sync:/sbin:/bin/sync shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown halt:x:7:0:halt:/sbin:/sbin/halt bash:x:1008:1008::/home/bash:/bin/bash nologin:x:1011:1011::/home/nologin:/sbin/nologin [root@centos8 ~]#egrep "^(.*)\>.*\<\1$" /etc/passwd sync:x:5:0:sync:/sbin:/bin/sync shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown halt:x:7:0:halt:/sbin:/sbin/halt bash:x:1008:1008::/home/bash:/bin/bash nologin:x:1011:1011::/home/nologin:/sbin/nologin
范例:面试题,算出所有人的年龄总和
[root@centos8 ~]#cat /data/nianling.txt xiaoming=20 xiaohong=18 xiaoqiang=22 [root@centos8 ~]#cut -d"=" -f2 /data/nianling.txt|tr '\n' + | grep -Eo ".*[0-9]"|bc 60 [root@centos8 ~]#grep -Eo "[0-9]+" /data/nianling.txt | tr '\n' + | grep -Eo ".*[0-9]"|bc 60
fgrep 命令
不支持正则表达式元字符;都当作字符本身的意义
当无需用到元字符去编写模式时,使用 fgrep性能更好;搜索几十万行、百万行 性能就发挥出来了
- -E : 支持使用扩展的正则表达式元字符
- -G:支持基本正则表达式
匹配中文
匹配: grep
grep -P '[\x{4e00}-\x{9f5a}]' xx.log rg '[\x{4e00}-\x{9f5a}]' xx.log # rigrep -l 显示文件 perl -CSD -ne 'print if /[\x{4e00}-\x{9fa5}]/' xx.log
匹配并删除 sed 命令:
LANG=C sed -i -e 's/[\x80-\xFF]//g' -i filename.txt
该命令中,LANG=C 表示设置字符集为 C 语言标准字符集,可以匹配 ASCII 和 非ASCII 字符。-i 选项表示直接修改源文件,s 命令表示替换操作, [\x80-\xFF]表示匹配所有非 ASCII 字符,//g 表示删除所有匹配到的字符。
perl 命令:
perl -CSD -pe 's/[\x{4e00}-\x{9fa5}]//g' -i AppConfig.java
这里的 -CSD 参数告诉 Perl 支持 Unicode 编码,-i 参数表示直接修改原始文件
rg
https://github.com/BurntSushi/ripgrep
sudo yum-config-manager --add-repo=https://copr.fedorainfracloud.org/coprs/carlwgeorge/ripgrep/repo/epel-7/carlwgeorge-ripgrep-epel-7.repo sudo yum install ripgrep
文本处理三剑客之 sed
工作原理
sed 即 Stream EDitor,和 vi 不同,sed是行编辑器


Sed是从文件或管道中读取一行,处理一行,输出一行;再读取一行,再处理一 行,再输出一行,直到最后一行。
- 每当处理一行时,把当前处理的行存储在临时缓冲区中,称为
模式空间 (PatternSpace),接着用sed命令处理缓冲区中的内容,处理完成后,把 缓冲区的内容送往屏幕。 - 接着处理下一行,这样不断重复,直到文件末尾。一次处理一行的设计模式使 得sed性能很高,sed在读取大文件时不会出现卡顿的现象。
如果使用vi命令打开几十M上百M的文件,明显会出现有卡顿的现象,这是因为vi 命令打开文件是一次性将文件加载到内存,然后再打开。Sed就避免了这种情况, 一行一行的处理,打开速度非常快,执行速度也很快
sed 基本用法
格式:
sed [option]... 'script;script;...' inputfile... 常用选项: -n #不输出模式空间内容到屏幕,即不自动打印 -e #多点编辑,表示或者 -f /PATH/SCRIPT_FILE #从指定文件中读取编辑脚本 -r, -E #使用扩展正则表达式 -i.bak #备份文件并原处编辑 -s #将多个文件视为独立文件,而不是单个连续的长文件流 #说明 -ir 不支持 -i -r 支持 -ri 支持 -ni 危险选项,会清空文件
script格式:
'地址命令'
地址格式:
1. 不给地址:对全文进行处理
2. 单地址:
#:指定的行,$:最后一行
/pattern/:被此处模式所能够匹配到的每一行
3. 地址范围:
#,# #从#行到第#行,3,6 从第3行到第6行
#,+# #从#行到+#行,3,+4 表示从3行到第7行
/pat1/,/pat2/ 从第一次匹配到的模式1到第二次匹配到模式2
#,/pat/ 从某行开始到第一次配到模式的行
4. 步进:~
1~2 奇数行;从第一行开始,每次加两行读取
2~2 偶数行。从第二行开始,每次加两行读取
命令:
p #打印当前模式空间内容,追加到默认输出之后 Ip #忽略大小写输出 d #删除模式空间匹配的行,并立即启用下一轮循环 a [\]text #在指定行后面追加文本,支持使用\n实现多行追加 i [\]text #在行前面插入文本 c [\]text #替换行为单行或多行文本 w /path/file #保存模式匹配的行至指定文件 r /path/file #读取指定文件的文本至模式空间中匹配到的行后 = #为模式空间中的行打印行号 ! #模式空间中匹配行取反处理 s/pattern/string/修饰符 查找替换,支持使用其它分隔符,可以是其它形式:s@@@,s###替换修饰符: 替换修饰符: g:全局替换; w /PATH/TO/SOMEFILE:将替换成功的结果保存至指定文件中; p:显示替换成功的行; I,i 忽略大小写 string: &是把前面每一个字符进行标记并输出 \1 \2 ... 分组反引 {COMMANDS}:可以把多个命令括起来,用来处理单个地址或者地址范围。 sed -n '5,9p;=' sed -n '5,9{p;=}'
感叹号在定址表达式后,表示对行进行筛选。表示满足条件的行不执行命令,但不满足的行会执行。 感叹号在命令的前面,表示满足条件的行不执行该命令,且不满足的行也不执行(不执行是因为没有被定址表达式匹配到)。这是对模式空间中的行筛选要执行的命令。
sed的默认行为:
sed模式空间中的内容,默认把一行读进模式空间,如果看到p就打印出来。但 sed有个默认行为,模式空间中的内容即使不作任何操作也会打印出来,再加p就 会又打印一次
范例:
[root@centos8 ~]#sed '' # 默认自动打印,相当于cat读入默认标准输入 welcome welcome to to [root@centos8 ~]#sed '' /etc/issue # 默认自动打印,相当于cat \S Kernel \r on an \m [root@centos8 ~]#sed 'p' /etc/issue \S \S Kernel \r on an \m Kernel \r on an \m [root@centos8 ~]#sed -n '' /etc/issue # -n 关闭自动打印 [root@centos8 ~]#sed -n 'p' /etc/issue \S Kernel \r on an \m [root@centos8 ~]#sed -n '1p' /etc/passwd root:x:0:0:root:/root:/bin/bash [root@centos8 ~]#ifconfig eth0 | sed '2p' eth0: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 inet6 fe80::20c:29ff:fe45:a8a1 prefixlen 64 scopeid 0x20<link> ether 00:0c:29:45:a8:a1 txqueuelen 1000 (Ethernet) RX packets 89815 bytes 69267453 (66.0 MiB) RX errors 0 dropped 0 overruns 0 frame 0 TX packets 115634 bytes 79827662 (76.1 MiB) TX errors 0 dropped 0 overruns 0 carrier 0 collisions 0 [root@centos8 ~]#ifconfig eth0 | sed -n '2p' inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 [root@centos8 ~]#sed -n '$p' /etc/passwd # 打印最后一行 postfix:x:89:89::/var/spool/postfix:/sbin/nologin [root@centos8 ~]#ifconfig eth0 |sed -n '/netmask/p' inet 10.0.0.8 netmask 255.255.255.0 broadcast 10.0.0.255 [root@centos8 ~]#df | sed -n '/^\/dev\/sd/p' /dev/sda2 104806400 4872956 99933444 5% / /dev/sda3 52403200 398860 52004340 1% /data /dev/sda1 999320 848568 81940 92% /boot [root@centos8 ~]#seq 10 | sed -n '3,6p' 3 4 5 6 seq 10 | sed -n '3,+4p' # 打印第3行到第7行 seq 10 | sed -n '3,$p' # 打印第3行到最后行 seq 10 |sed -n '1~2p' # 打印奇数行。从第1行隔2行打印 seq 10 |sed -n '2~2p' # 打印偶数行。从第2行隔2行打印 seq 10 |sed '1~2d' # 打印除奇数行。 seq 10 |sed '2~2d' # 打印除偶数行。 # -e 来表示或者 sed -e '2d' -e '4d' seq.log # 打印除第2 第4行 sed '2d;4d' seq.log # 打印除第2 第4行 sed -i.orig '2d;4d' seq.log # 删除文件第2 第4行,并保存原文件为seq.log.orig sed -i '/^listen 9527/a listen 80 \nlisten 8080' /etc/httpd/conf/httpd.conf sed -i '/^#/d' fstab #删除所有以#开头的行 sed -n '/^#/!p' fstab #只显示非#开头的行 sed -n '/^[[:digit:]]/p' relax_read_count.log.2017-01-17 |less #只打印以数字开头的行 #修改网卡配置 sed -Ei.bak '/^GRUB_CMDLINE_LINUX/s/(.*)(")$/\1 net.ifnames=0\2/' /etc/default/grub
范例:
sed '2p' /etc/passwd sed -n '2p' /etc/passwd sed -n '1,4p' /etc/passwd sed -n '/root/p' /etc/passwd sed -n '2,/root/p' /etc/passwd 从2行开始 sed -n '/^$/=' file 显示空行行号 sed -n '/./p' a.sh : 显示非空行,但对制表符无效 sed -n -e '/^$/p' -e '/^$/=' file Sed'/root/a\superman' /etc/passwd行后 sed '/root/i\superman' /etc/passwd 行前 sed '/root/c\superman' /etc/passwd 代替行 sed '/^$/d' file sed '1,10d' file nl /etc/passwd | sed '2,5d' nl /etc/passwd | sed '2a tea' sed 's/test/mytest/g' example sed -n 's/root/&superman/p' /etc/passwd 单词后 # &是把前面每一个字符进行标记并输出 sed -n 's/root/superman&/p' /etc/passwd 单词前 sed -e 's/dog/cat/' -e 's/hi/lo/' pets sed -n 's/^.//gp' /etc/fstab # 删除文件每行中的第一个字符 sed -nr 's/.$//p' /etc/passwd # 删除文件每行的最后一个字符 sed -i.bak 's/dog/cat/g' pets
范例:取IP 地址
[root@centos8 ~]#ifconfig eth0 |sed -nr "2s/[^0-9]+([0-9.]+).*/\1/p" 10.0.0.8 [root@centos8 ~]#ifconfig eth0 | sed -rn '2s/^[^0-9]+([0-9.]+) .*$/\1/p' 10.0.0.8 [root@centos8 ~]#ifconfig eth0 | sed -n '2s/^.*inet //p' | sed -n 's/ netmask.*//p' 10.0.0.8 [root@centos8 ~]#ifconfig eth0 | sed -n '2s/^.*inet //;s/ netmask.*//p' 10.0.0.8 [root@centos8 ~]#ifconfig eth0 | sed -rn '2s/(.*inet )([0-9].*)( netmask.*)/\2/p' 10.0.0.8
范例:取基名和目录名
echo "/etc/sysconfig/network-scripts/" |sed -r 's#(^/.*/)([^/]+/?)#\2#' 取基名 echo "/etc/sysconfig/network-scripts/" |sed -r 's#(^/.*/)([^/]+/?)#\1#' 取目录 #取目录名 [root@centos8 ~]#echo /etc/sysconfig/ | sed -rn 's#(.*)/([^/]+)/?#\1#p' /etc #取基名 [root@centos8 ~]#echo /etc/sysconfig/ | sed -rn 's#(.*)/([^/]+)/?#\2#p' sysconfig
范例:将#开头的行删除#
[root@centos8 ~]#sed -ri.bak '/^#/s/^#//' /etc/fstab
范例:取分区利用率
[root@centos8 ~]#df | sed -nr '/^\/dev\/sd/s# .* ([0-9]+)%.*# \1#p'
/dev/sda2 3
/dev/sda5 1
/dev/sda1 14
范例:修改内核参数
[root@centos8 ~]#sed -nr '/^GRUB_CMDLINE_LINUX/s/"$/ net.ifnames=0"/p' /etc/default/grub GRUB_CMDLINE_LINUX="crashkernel=auto resume=UUID=8363289d-138e-4e4a-abaf- 6e028babc924 rhgb quiet net.ifnames=0" [root@centos8 ~]#sed -rn '/^GRUB_CMDLINE_LINUX=/s@(.*)"$@\1 net.ifnames=0"@p' /etc/default/grub GRUB_CMDLINE_LINUX="crashkernel=auto resume=UUID=a0efb2bb-8227-4317-a79d- 0a70d515046c rhgb quiet net.ifnames=0" [root@centos8 ~]#sed -rn '/^GRUB_CMDLINE_LINUX=/s@"$@ net.ifnames=0"@p' /etc/default/grub GRUB_CMDLINE_LINUX="crashkernel=auto resume=UUID=a0efb2bb-8227-4317-a79d- 0a70d515046c rhgb quiet net.ifnames=0 net.ifnames=0"
范例:修改网卡名称
[root@centos8 ~]#sed -ri '/^GRUB_CMDLINE_LINUX=/s@"$@ net.ifnames=0"@' /etc/default/grub #centos7,8 [root@centos8 ~]#grub2-mkconfig -o /boot/grub2/grub.cfg #ubuntu [root@ubuntu ~]#grub-mkconfig -o /boot/grub/grub.cfg
范例:修改配置文件
[root@centos6 ~]#sed -e '/^#<VirtualHost/,/^#<\/VirtualHost>/s@#@@' -e '/^#NameVirtualHost/s@#@@' /etc/httpd/conf/httpd.conf
"|" "(" ")" 等属于正则表达式的POSIX扩展, 在sed里不直接支持需要加转义 字符”" 。 也就是说得这样使用: | ( ) ,支持扩展-r 或 -E
echo Welcome to Me | sed 's/\w\+/[&]/g' #&是把前面每一个字符进行标记并输出 [root@localhost ~]# echo Welcome to M | sed 's/\w\+/[&]/g' [Welcome] [to] [M]
范例:将非#开头的行加#
sed -rn "s/^[^#]/#&/p" /etc/fstab # &是把前面每一个字符进行标记并输出 sed -rn 's/^[^#](.*)/#\1/p' /etc/fstab sed -rn '/^#/!s@^@#@p' /etc/fstab
范例:查看配置文件,删除#号头行空白行
sed -r '/^(#|$)/d' /etc/httpd/conf/httpd.conf sed -r '/^#|^$/d' /etc/httpd/conf/httpd.conf
范例:引用变量
[root@centos8 ~]#echo|sed "s/^/$RANDOM.rmvb/" 5242.rmvb [root@centos8 ~]#echo|sed 's/^/$RANDOM.rmvb/' $RANDOM.rmvb [root@centos8 ~]#echo|sed 's/^/'''$RANDOM'''.rmvb/'
范例:/ 变为.
# / 变为. REPOSITORY=gcr.io/google_containers interval=. [root@stor01 ~]# sed 's#/#'"$interval"'#g'<<<${REPOSITORY%/}/ gcr.io.google_containers.
练习1:删除/boot/grub/grub2.cfg文件中所有以空白字符开头的行的行首的所有空白字符; sed 's@^[[:space:]]\+@@' /etc/grub2.cfg 练习2:删除/etc/fstab文件中所有以#开头的行的行首的#号及#后面的所有空白字符; sed 's@^#[[:space:]]*@@' /etc/fstab 练习3:输出一个绝对路径给sed命令,取出其目录,其行为类似于dirname; echo "/var/log/messages/" | sed 's@[^/]\+/\?$@@' echo "/var/log/messages" | sed -r 's@[^/]+/?$@@'
sed 高级用法
sed中除了模式空间,还另外还支持 保持空间(Hold Space) ,利用此空间,
可以将模式空间(PatternSpace)中的数据,临时保存至保持空间,从而后续接
着处理,实现更为强大的功能。
常见的高级命令
- P 打印模式空间开端至\n内容,并追加到默认输出之前
- h 把模式空间中的内容覆盖至保持空间中
- H 把模式空间中的内容追加至保持空间中
- g 从保持空间取出数据覆盖至模式空间
- G 从保持空间取出内容追加至模式空间
- x 把模式空间中的内容与保持空间中的内容进行互换
- n 读取匹配到的行的下一行覆盖至模式空间
- N 读取匹配到的行的下一行追加至模式空间
- d 删除模式空间中的行
- D 如果模式空间包含换行符,则删除直到第一个换行符的模式空间中的文本, 并不会读取新的输入行,而使用合成的模式空间重新启动循环。如果模式空间 不包含换行符,则会像发出d命令那样启动正常的新循环
范例:
sed -n 'n;p' FILE sed '1!G;h;$!d' FILE sed ‘N;D’FILE # 显示最后一行 seq 10 |sed '3h;9G;9!d' sed '$!N;$!D' FILE sed '$!d' FILE sed ‘G’ FILE sed ‘g’ FILE sed ‘/^$/d;G’ FILE sed 'n;d' FILE sed -n '1!G;h;$p' FILE sed -n 'n;p' FILE:# 显示偶数行; sed '1!G;h;$!d' FILE:# 逆序显示文件的内容;1!G:第1行保持空间内容不追加到模式空间,h:把模式空间中的内容覆盖至保持空间中,$!d:除最后一行外的行从模式空间中删除 sed ’$!d' FILE:取出最后一行; sed '$!N;$!D' FILE:取出文件后两行; sed '/^$/d;G' FILE:删除原有的所有空白行,而后为所有的非空白行后添加一个空白行; sed 'n;d' FILE:显示奇数行; sed 'N;p' sed 'G' FILE:在原有的每行后方添加一个空白行;

范例:上下行合并
方法一 sed -n '{N;s/\n/\t/p}' test.txt 方法二: awk '{tmp=$0;getline;print tmp"\t"$0}' test.txt [root@nginx001 ~]# curl -s -u wowotuan:wowotuan 172.16.0.22:8080/v2/apps?embed=apps.count|jq '.apps[]|.id ,.instances' |sed -n '{N;s/\n/ /p}' |sort -nr -k2 "/yuncapital-yzprod" 2 "/xyscm-foodsafetyweb-yzprod" 2 "/xyscm-cost-reduction-web-yzprod" 2 "/jobcenter-yzprod" 2 "/dbos-web-yzprod" 2 "/xyscm-warehousecenter-yzprod" 1 "/xyscm-ub-web-yzprod" 1 "/xyscm-taskcenter-yzprod" 1 "/xyscm-me-warehousecenter-yzprod" 1 "/xyscm-me-erpcenter-yzprod" 1
运行sed脚本
# Time: 2018-12-09T10:42:25.350158+08:00 # User@Host: miying[miying] @ [10.1.1.9] Id: 930992 # Query_time: 0.357271 Lock_time: 0.000021 Rows_sent: 1 Rows_examined: 21045 SET timestamp=1544323345; SELECT SUM(duration) FROM `user_listening_log` WHERE (`user_account_id`='xxxxxxxxxxxxxxxxxxxxxxxxxxxxx') AND (`record_date`='2018-12-09') AND (`product_id`='yyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyy'); # Time: 2018-12-09T10:42:25.353119+08:00 # User@Host: miying[miying] @ [10.1.1.9] Id: 930993 # Query_time: 0.345233 Lock_time: 0.000025 Rows_sent: 1 Rows_examined: 21045 SET timestamp=1544323345; SELECT SUM(duration) FROM `user_listening_log` WHERE (`user_account_id`='e359112a3f2c4d968e710e003f7b0a4c') AND (`record_date`='2018-12-09') AND (`product_id`='yyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyyy'); 取出查询日志里的查询时间和表。也就是上面框起来的红色时间、黄色的表。输出格式为"0.12121 user_account"。文件里就上面两种格式。 #!/usr/bin/sed -nf /Query_time: /{ :a /FROM/I{ s|^# Query_time: ([0-9]+\.[0-9]+).*FROM \W?([a-zA-Z_]+)\W?.*$|\1 \2|Ip d } N ba }


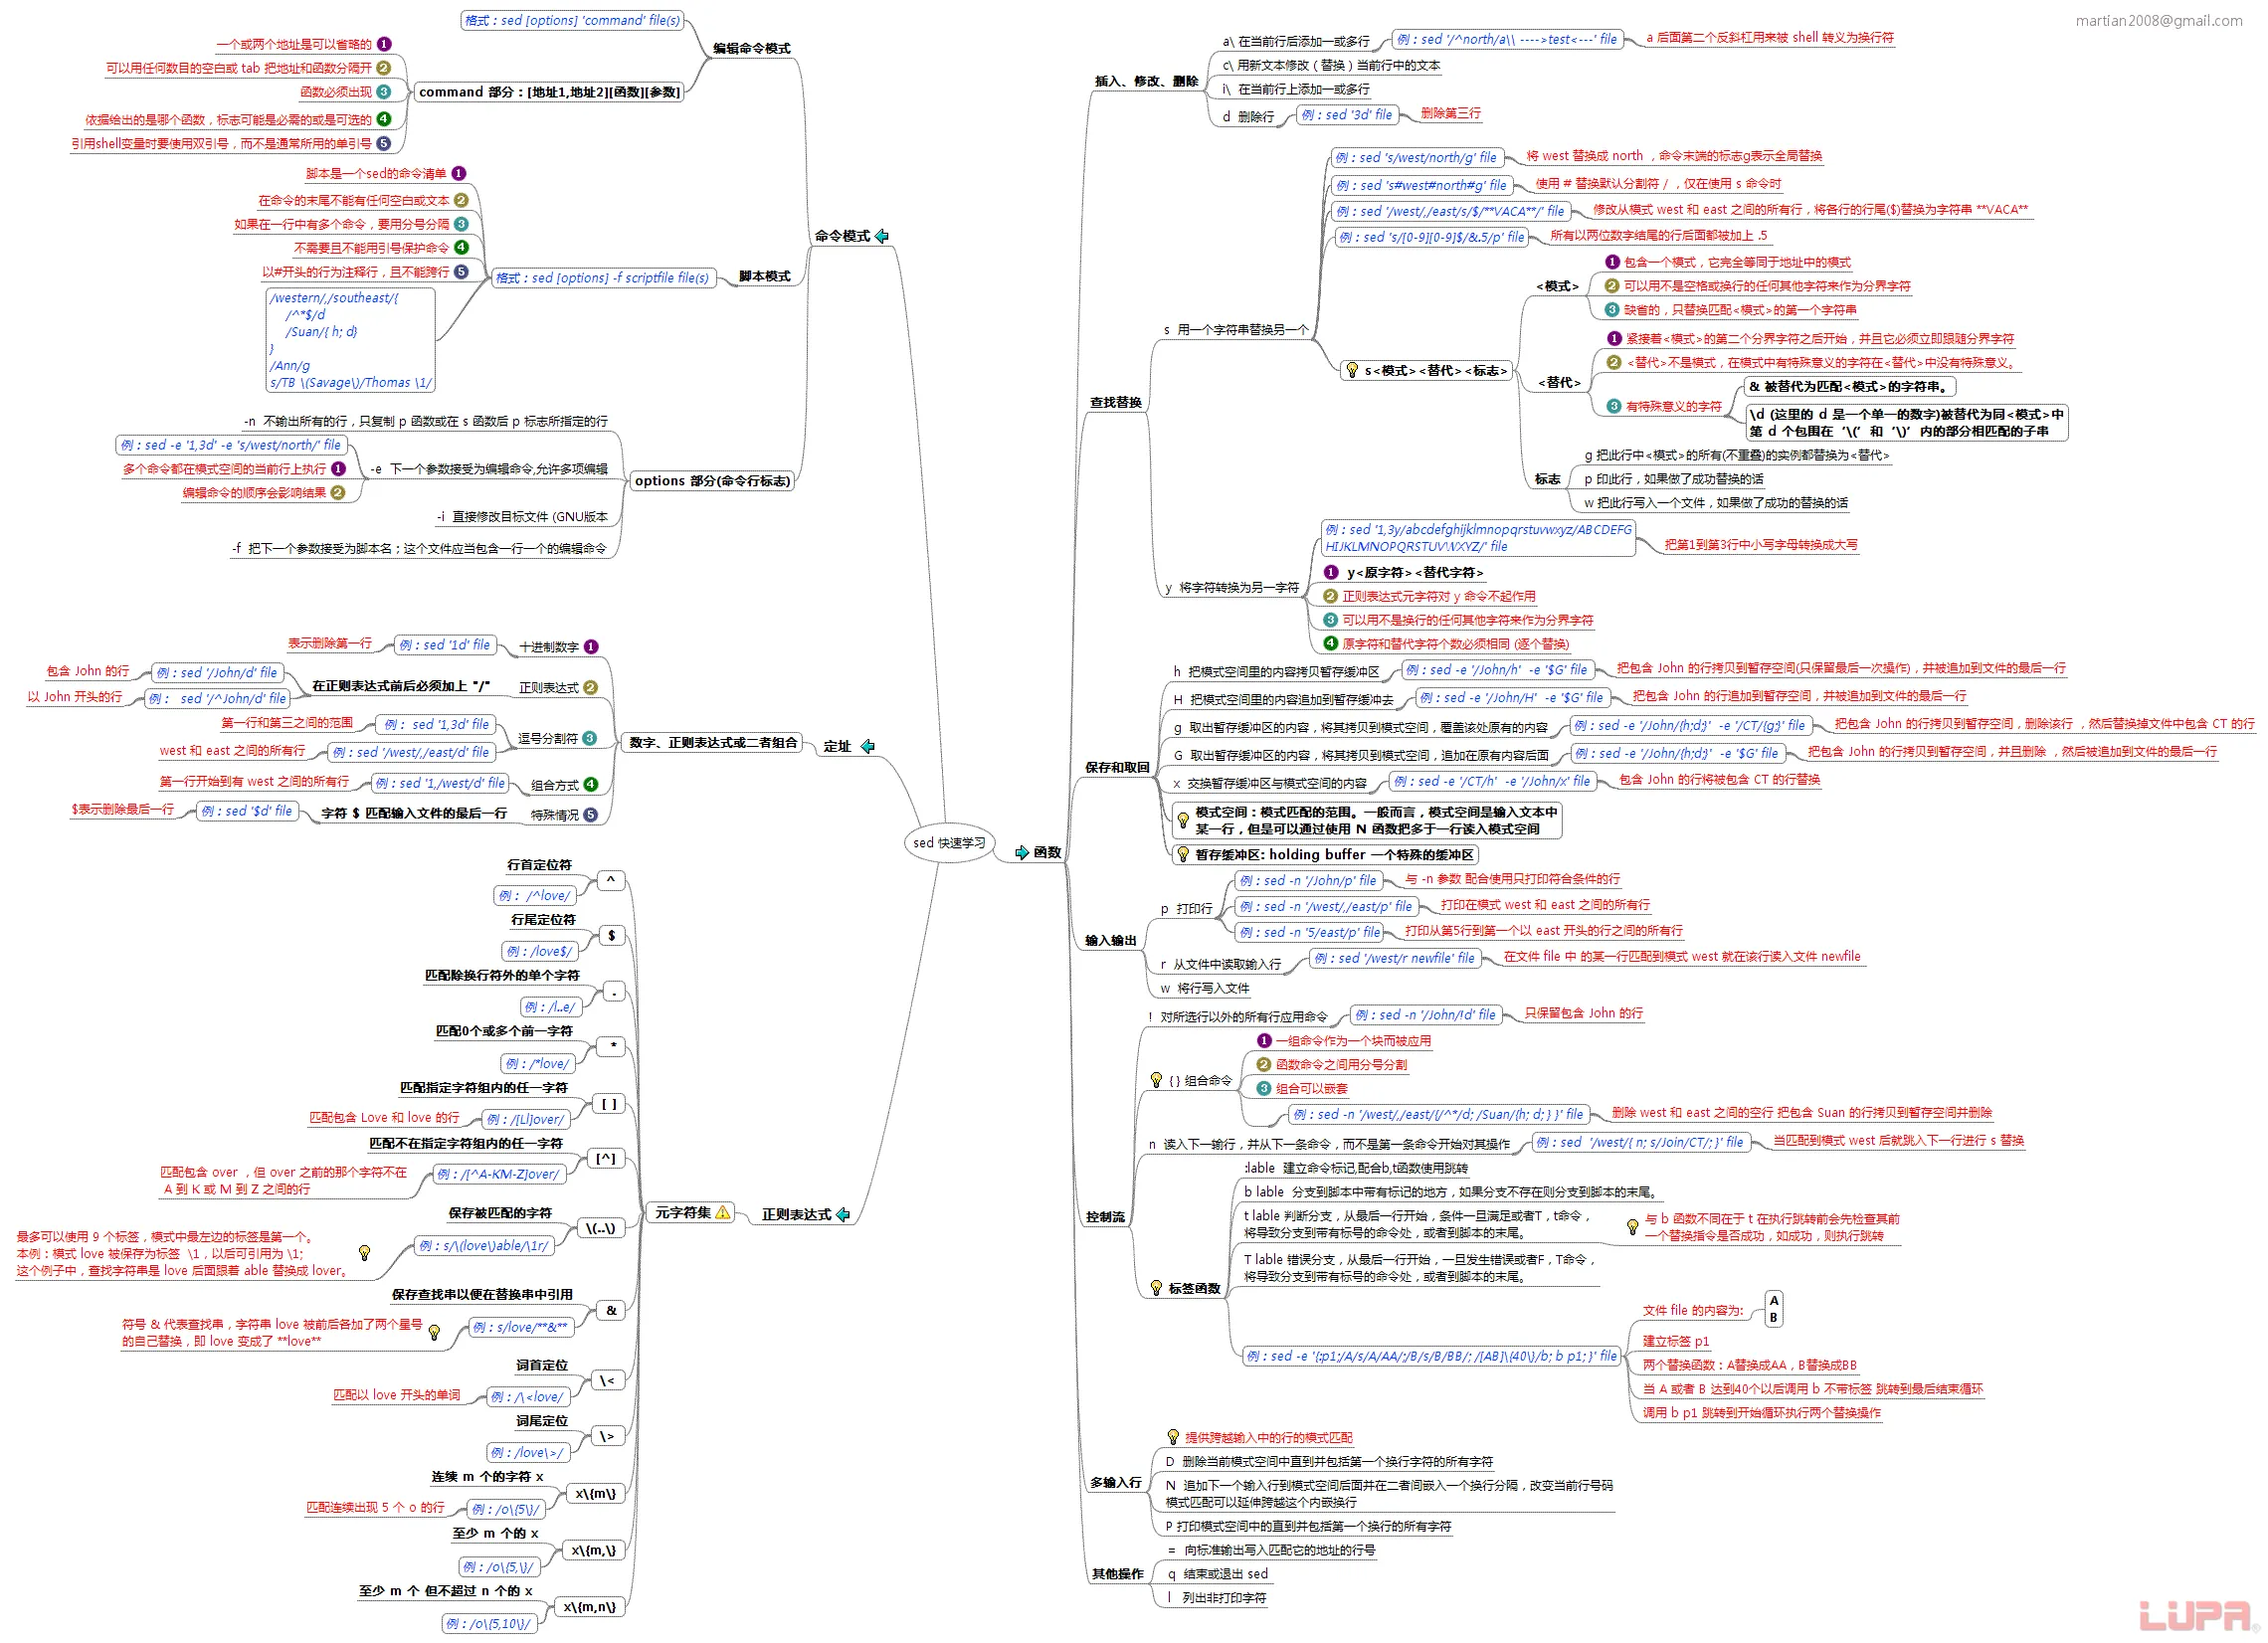
文本处理三剑客之 awk
awk 工作原理和基本用法说明
awk:Aho, Weinberger, Kernighan采用三个作者的名称首字母简写,报告生成 器,格式化文本输出,GNU/Linux发布的AWK目前由自由软件基金会(FSF)进行 开发和维护,通常也称它为
GNU AWK 有多种版本:
- AWK:原先来源于 AT & T 实验室的的AWK
- NAWK:New awk,AT & T 实验室的AWK的升级版
GAWK:即GNU AWK。所有的GNU/Linux发布版都自带GAWK,它与AWK和NAWK完全兼容
Linux上awk是gawk的连接文件 [root@centos7 scripts]# which awk /usr/bin/awk [root@centos7 scripts]# ls -l /usr/bin/awk lrwxrwxrwx. 1 root root 4 12月 10 16:47 /usr/bin/awk -> gawk [root@centos7 scripts]# man gawk
gawk:模式扫描和处理语言,可以实现下面功能
- 文本处理
- 输出格式化的文本报表
- 执行算数运算
- 执行字符串操作
格式:
awk [options] 'program' var=value file… awk [options] -f programfile var=value file…
说明:
program通常是被放在单引号中,并可以由三种部分组成
- BEGIN语句块
- 模式匹配的通用语句块
- END语句块
常见选项:
- -F "分隔符" 指明输入时用到的字段分隔符,默认的分隔符是若干个连续空白符
- -v var=value 变量赋值
Program格式:
pattern{action statements;..}
pattern:决定动作语句何时触发及触发事件,比如:BEGIN,END,正则表达式等
action statements:对数据进行处理,放在{}内指明,常见:print, printf
awk 工作过程

- 第一步:执行BEGIN{action;… }语句块中的语句
- 第二步:从文件或标准输入(stdin)读取一行,然后执行pattern{ action;… }语句块,它逐行扫描文件,从第一行到最后一行重复这个过程,直到文件全 部被读取完毕。
- 第三步:当读至输入流末尾时,执行END{action;…}语句块
BEGIN语句块在awk开始从输入流中读取行之前被执行,这是一个可选的语句块, 比如变量初始化、打印输出表格的表头等语句通常可以写在BEGIN语句块中
END语句块在awk从输入流中读取完所有的行之后即被执行,比如打印所有行的分 析结果这类信息汇总都是在END语句块中完成,它也是一个可选语句块
pattern语句块中的通用命令是最重要的部分,也是可选的。如果没有提供 pattern语句块,则默认执行{print },即打印每一个读取到的行,awk读取的每 一行都会执行该语句块
分割符、域和记录
- 由分隔符分隔的字段(列column,域field)标记$1,$2…$n称为域标识,$0为 所有域,注意:和shell中变量$符含义不同
- 文件的每一行称为记录record
- 如果省略action,则默认执行 print $0 的操作
常用的action分类
- output statements:输出语句print,printf
- Expressions:算术,比较表达式等
- Compound statements:组合语句
- Control statements:控制语句if, while等
- input statements控制语句
awk控制语句
- { statements;… } 组合语句
- if(condition) {statements;…}
- if(condition) {statements;…} else {statements;…}
- while(conditon) {statments;…}
- do {statements;…} while(condition)
- for(expr1;expr2;expr3) {statements;…}
- break
- continue
- exit
动作 print
格式: print item1, item2, …
说明:
- 逗号分隔符
- 输出item可以字符串,也可是数值;当前记录的字段、变量或awk的表达式
- 如省略item,相当于print $0打印整行
- 固定字符符需要用“ ” 引起来,而变量和数字不需要
范例:
[root@centos8 ~]#awk '{print "hello,awk"}' [root@centos8 ~]#seq 10 | awk '{print "hello,awk"}' hello,awk hello,awk hello,awk hello,awk hello,awk hello,awk hello,awk hello,awk hello,awk hello,awk [root@centos8 ~]#seq 3 | awk '{print 2*3}' 6 6 6 [root@centos8 ~]#awk -F: '{print "wang"}' /etc/passwd [root@centos8 ~]#awk -F: '{print}' /etc/passwd [root@centos8 ~]#awk -F: '{print $0}' /etc/passwd [root@centos8 ~]#awk -F: '{print $1,$3}' /etc/passwd [root@centos8 ~]#awk -F: '{print $1"\t"$3}' /etc/passwd [root@centos8 ~]#grep "^UUID" /etc/fstab |awk {'print $2,$3'} / xfs /boot ext4 /data xfs swap swap
面题:取出网站访问量最大的前3个IP
[root@VM_0_10_centos logs]# awk '{print $1}' nginx.access.log-20200428|sort | uniq -c |sort -nr|head -3 5498 122.51.38.20 2161 117.157.173.214 953 211.159.177.120 [root@centos8 ~]#awk '{print $1}' access_log |sort |uniq -c|sort -nr|head 4870 172.20.116.228 3429 172.20.116.208 2834 172.20.0.222 2613 172.20.112.14 2267 172.20.0.227 2262 172.20.116.179 2259 172.20.65.65 1565 172.20.0.76 1482 172.20.0.200 1110 172.20.28.145
面试题:取出分区利用率
[root@centos8 ~]#df | awk '{print $1,$5}' Filesystem Use% devtmpfs 0% tmpfs 0% tmpfs 2% tmpfs 0% /dev/sda2 3% /dev/sda3 1% /dev/sda1 15% tmpfs 0% #使用扩展的正则表达式 [root@centos8 ~]#df | awk -F"[[:space:]]+|%" '{print $5}' Use 0 0 1 0 5 1 92 1 [root@centos8 ~]#df | awk -F'[[:space:]]+|%' '{print $1,$5}' Filesystem Use devtmpfs 0 tmpfs 0 tmpfs 2 tmpfs 0 /dev/sda2 3 /dev/sda3 1 /dev/sda1 15 tmpfs 0 [root@centos8 ~]#df | grep "^/dev/sd" | awk -F"[[:space:]]+|%" '{print $5}' 5 1 92 [root@centos8 ~]#df | grep '^/dev/sd'| awk -F'[[:space:]]+|%' '{print $1,$5}' /dev/sda2 3 /dev/sda3 1 /dev/sda1 15 [root@centos8 ~]#df | awk -F"[[:space:]]+|%" '/^\/dev\/sd/{print $5}' 5 1 92 [root@centos8 ~]#df | awk -F'[[:space:]]+|%' '/^\/dev\/sd/{print $1,$5}' /dev/sda2 3 /dev/sda3 1 /dev/sda1 15
面试题:取 ifconfig 输出结果中的IP地址
[root@centos8 ~]#ifconfig eth0 | awk '/netmask/{print $2}' 10.0.0.8 [root@centos6 ~]#ifconfig eth0 |awk -F " +|:" '/Mask/{print $4}' 10.0.0.6 [root@centos8 ~]#ifconfig eth0| sed -rn '2s/^[^0-9]+([0-9.]+) .*$/\1/p' 10.0.0.8 [root@centos6 ~]#ifconfig eth0| sed -rn '2s/^[^0-9]+([0-9.]+) .*$/\1/p' 10.0.0.6
面试题:文件host_list.log如下格式,请提取”.me.com”前面的主机名部分并 写入到回到该文件中
[root@centos8 ~]#cat host_list.log 1 www.me.com 2 blog.me.com 3 study.me.com 4 linux.me.com 5 python.me.com [root@centos8 ~]#awk -F"[ .]" '{print $2}' host_list.log www blog study linux python [root@centos8 ~]#awk -F"[ .]" '{print $2}' host_list.log >> host_list.log [root@centos8 ~]#cat host_list.log 1 www.me.com 2 blog.me.com 3 study.me.com 4 linux.me.com 5 python.me.com www blog study linux python
awk变量
awk中的变量分为:内置和自定义变量
常见的内置变量
FS:input field seperator输入字段分隔符,默认为空白字符; OFS:output field seperator,输出字段分隔符,默认为空白字符; RS:input record seperator,输入时的换行符; ORS:output record seperator,输出时的换行符; NF: number of field,字段数量 NR: number of record,行数 FNR: 每一个文件单独计录行数 FILENAME: 当前文件名 ARGC: 命令行参数的个数 ARGV: 数组,保存了命令行中的各参数 ARGIND 命令行中文件序号
- FS:输入字段分隔符,默认为空白字符,功能相当于 -F
范例:
awk -v FS=':' '{print $1,FS,$3}' /etc/passwd awk -v FS=":" '{print $1FS$3}' /etc/passwd awk –F: '{print $1,$3,$7}' /etc/passwd S=:;awk -v FS=$S '{print $1FS$3}' /etc/passwd [root@centos8 ~]#awk -v FS=":" '{print $1FS$3}' /etc/passwd |head -n3 root:0 bin:1 daemon:2 [root@centos8 ~]#S=:;awk -F$S '{print $1,$3}' /etc/passwd|head -n3 root 0 bin 1 daemon 2 [root@centos8 ~]# #-F 和 FS变量功能一样,同时使用会冲突 [root@centos8 ~]#awk -v FS=":" -F";" '{print $1FS$3}' /etc/passwd |head -n3 root:x:0:0:root:/root:/bin/bash; bin:x:1:1:bin:/bin:/sbin/nologin; daemon:x:2:2:daemon:/sbin:/sbin/nologin; [root@centos8 ~]#awk -F";" -v FS=":" '{print $1FS$3}' /etc/passwd |head -n3 root:0 bin:1 daemon:2 [root@centos8 ~]#
OFS:输出字段分隔符,默认为空白字符 范例:
[root@centos8 ~]#awk -v FS=':' '{print $1,$3,$7}' /etc/passwd|head -n1 root 0 /bin/bash [root@centos8 ~]#awk -v FS=':' -v OFS=':' '{print $1,$3,$7}' /etc/passwd|head -n1 root:0:/bin/bash
RS:输入记录record分隔符,指定输入时的换行符 范例:
awk -v RS=' ' ‘{print }’ /etc/passwd
ORS:输出记录分隔符,输出时用指定符号代替换行符 范例:
awk -v RS=' ' -v ORS='###' '{print $0}' /etc/passwd
NF:字段数量 范例:
#引用变量时,变量前不需加$ [root@centos8 ~]#awk -F:'{print NF}' /etc/fstab [root@centos8 ~]#awk -F:'{print $(NF-1)}' /etc/passwd #$(NF-1) 最后一列减1 [root@centos8 ~]#ls /misc/cd/BaseOS/Packages/*.rpm |awk -F"." '{print $(NF-1)}'|sort |uniq -c 389 i686 208 noarch 1060 x86_64
面试题:接数最多的前3个IP
[root@centos8 ~]#awk -F" +|:" '{print $(NF-2)}' ss.log |sort |uniq -c|sort -nr|head -n3 12 223.88.255.148 11 119.250.197.118 10 183.202.63.36 [root@centos8 ~]#awk -F" +|:" '/^ESTAB/{print $(NF-2)}' ss.log |sort |uniq -c|sort -nr|head -n3 12 223.88.255.148 10 183.202.63.36 9 117.152.155.119 [root@centos8 ~]#ss -nt |grep "^ESTAB" | awk -F"[[:space:]]+|:" '{print $(NF-2)}' 10.0.0.1 10.0.0.7 10.0.0.1 [root@centos8 ~]#ss -nt |awk -F"[[:space:]]+|:" '/^ESTAB/{print $(NF-2)}' [root@centos8 ~]#ss -nt|awk -F: '{print $(NF-1)}' |awk '/^[0-9]/{print $NF}'|sort |uniq -c |head -n 3
范例:每十分钟检查将连接数超过100个以上的IP放入黑名单拒绝访问
[root@centos8 ~]#cat deny_dos.sh LINK=100 while true;do ss -nt | awk -F"[[:space:]]+|:" '/^ESTAB/{print $(NF-2)}'|sort |uniq -c|while read count ip;do if [ $count -gt $LINK ];then iptables -A INPUT -s $ip -j REJECT fi done done [root@centos8 ~]#chmod +x /root/deny_dos.sh [root@centos8 ~]#crontab -e [root@centos8 ~]#crontab -l */10 * * * * /root/deny_dos.sh
范例:
[root@centos8 ~]#cat deny_dos.sh IPLIST=`awk -F" +|:" '/^ESTAB/{print $(NF-2)}' ss.log |sort |uniq -c|sort -nr|head -3|awk '{print $2}'` for ip in $IPLIST;do iptables -A INPUT -s $ip -j REJECT done
NR:记录的编号,行的数量 范例:
[root@centos8 ~]#awk '{print NR,$0}' /etc/issue /etc/centos-release 1 \S 2 Kernel \r on an \m 3 4 CentOS Linux release 8.1.1911 (Core)
范例:取ifconfig输出结果中的IP地址
[root@centos8 ~]#ifconfig eth0 | awk '/netmask/{print $2}' 10.0.0.8 [root@centos8 ~]#ifconfig eth0 | awk 'NR==2{print $2}' 10.0.0.8
范例:
[root@centos8 ~]#awk -F: '{print NR}' /etc/passwd 1 2 3 ....... [root@centos8 ~]#awk -F: 'END{print NR}' /etc/passwd 57 [root@centos8 ~]#awk -F: 'BEGIN{print NR}' /etc/passwd 0
FNR:各文件分别计数,记录的编号 范例:
awk '{print FNR}' /etc/fstab /etc/inittab [root@centos8 ~]#awk '{print NR,$0}' /etc/issue /etc/redhat-release 1 \S 2 Kernel \r on an \m 3 4 CentOS Linux release 8.0.1905 (Core) [root@centos8 script40]#awk '{print FNR,$0}' /etc/issue /etc/redhat-release 1 \S 2 Kernel \r on an \m 3 1 CentOS Linux release 8.0.1905 (Core)
- FILENAME:当前文件名
范例:
[root@centos8 ~]#awk '{print FILENAME}' /etc/fstab [root@centos8 ~]#awk '{print FNR,FILENAME,$0}' /etc/issue /etc/redhat-release 1 /etc/issue \S 2 /etc/issue Kernel \r on an \m 3 /etc/issue 1 /etc/redhat-release CentOS Linux release 8.0.1905 (Core)
ARGC:命令行参数的个数 范例:
[root@centos8 ~]#awk '{print ARGC}' /etc/issue /etc/redhat-release 3 3 3 3 [root@centos8 ~]#awk 'BEGIN{print ARGC}' /etc/issue /etc/redhat-release 3
ARGV:数组,保存的是命令行所给定的各参数,每一个参数:ARGV[0],…… 范例:
[root@centos8 ~]#awk 'BEGIN{print ARGV[0]}' /etc/issue /etc/redhat-release awk [root@centos8 ~]#awk 'BEGIN{print ARGV[1]}' /etc/issue /etc/redhat-release /etc/issue [root@centos8 ~]#awk 'BEGIN{print ARGV[2]}' /etc/issue /etc/redhat-release /etc/redhat-release [root@centos8 ~]#awk 'BEGIN{print ARGV[3]}' /etc/issue /etc/redhat-release [root@centos8 ~]#
ARGIND 命令行中文件序号
范例:2个文件比较
我要比较a和b两个文件;
a b
1 1
qw 2
qq d
123 cd
我怎么才能列出b文件中完全不包含a文件的行??
解答: awk 'ARGIND==1 {a[$0]} ARGIND>1&&!($0 in a) {print $0}' a b
或者: awk 'NR==FNR {a[$0]} NR>FNR&&!($0 in a) {print $0}' a b
代码解释:
ARGIND==1{a[$0]}
#ARGIND==1 判断是否正在处理第一个文件,本例为文件a
# {a[$0]} 初始化(或叫做定义)a[$0]
ARGIND>1&&!($0 in a){print $0}
#ARGIND>1 判断是否在处理第二个或第n个文件,本例只有一个文件b
#并且判断a[$0]是否未定义,然后打印$0
范例:处理 2 个文件
当awk读取的文件只有两个的时候,比较常用的有两种方法:
(1) 一种是 awk 'NR==FNR{...}NR>FNR{...}' file1 file2 或 awk 'NR==FNR{...}NR!=FNR{...}' file1 file2
(2) 另一种是 awk 'NR==FNR{...;next}{...}' file1 file2
awk 'NR==FNR{...}NR>FNR{...}' file1 file2
# 读入file1的时候,已读入file1的记录数FNR一定等于awk已读入的总记录数NR,因为file1是awk读入的首个文件,故读入file1时执行前一个命令块{...}
# 读入file2的时候,已读入的总记录数NR一定>读入file2的记录数FNR,故读入file2时执行后一个命令块{...}
awk 'NR==FNR{...;next}{...}' file1 file2
# 读入file1时,满足NR==FNR,先执行前一个命令块,但因为其中有next命令,故后一个命令块{...}是不会执行的
# 读入file2时,不满足NR==FNR,前一个命令块{..}不会执行,只执行后一个命令块{...}
当awk处理的文件超过两个时,显然上面那种方法就不适用了。因为读第3个文件 或以上时,也满足NR>FNR (NR!=FNR),显然无法区分开来,所以就要用到更通用 的方法了:
1. ARGIND # 当前被处理参数标志
awk 'ARGIND==1{...}ARGIND==2{...}ARGIND==3{...}... ' file1 file2 file3 ...
2. ARGV # 命令行参数数组
awk 'FILENAME==ARGV[1]{...}FILENAME==ARGV[2]{...}FILENAME==ARGV[3]{...}...' file1 file2 file3 ...
3. 把文件名直接加入判断
awk 'FILENAME=="file1"{...}FILENAME=="file2"{...}FILENAME=="file3"{...}...' file1 file2 file3 ...
[root@app-nginx03 logs]# cat Top_app-nginx03_adverttisement_access_2017-09-12.log.csv
1,-
1,/hdzuoye_advertise/advertise/hadvertiseErrorGetter.do?positionId=2
7,/hdzuoye_advertise/advertise/getCurrentADByPosition.do
38,/hdzuoye_advertise/advertise/getCurrentADByPosition.do?positionId=2&adCount=1
20092415,/hdzuoye_advertise/advertise/addAdvertiseAmountLog.do
[root@app-nginx03 logs]# cat Top_app-nginx02_adverttisement_access_2017-09-12.log.csv
4,-
5,/hdzuoye_advertise/advertise/getCurrentADByPosition.do?positionId=2&adCount=1
1153013,/hdzuoye_advertise/advertise/addAdvertiseAmountLog.do
[root@app-nginx03 logs]# awk -F\, 'NR==FNR{n[$2]=$1;next} {print n[$2]+$1","$2}' Top_app-nginx02_adverttisement_access_2017-09-12.log.csv Top_app-nginx03_adverttisement_access_2017-09-12.log.csv
5,-
1,/hdzuoye_advertise/advertise/hadvertiseErrorGetter.do?positionId=2
7,/hdzuoye_advertise/advertise/getCurrentADByPosition.do
43,/hdzuoye_advertise/advertise/getCurrentADByPosition.do?positionId=2&adCount=1
21245428,/hdzuoye_advertise/advertise/addAdvertiseAmountLog.do
[root@app-nginx03 logs]# awk -F\, 'ARGIND==1{n[$2]=$1} ARGIND==2 {print n[$2]+$1","$2}' Top_app-nginx02_adverttisement_access_2017-09-12.log.csv Top_app-nginx03_adverttisement_access_2017-09-12.log.csv
5,-
1,/hdzuoye_advertise/advertise/hadvertiseErrorGetter.do?positionId=2
7,/hdzuoye_advertise/advertise/getCurrentADByPosition.do
43,/hdzuoye_advertise/advertise/getCurrentADByPosition.do?positionId=2&adCount=1
21245428,/hdzuoye_advertise/advertise/addAdvertiseAmountLog.do
自定义变量(区分字符大小写)
- -v var=value
- 在program中直接定义
注意:
- 引用字段变量是不需要加\(符的,引用字段可以加\)
- 外部变量需要用引号分离出,使shell能解析
范例:
awk -v test='hello gawk' '{print test}' /etc/fstab awk -v test='hello gawk' 'BEGIN{print test}' awk 'BEGIN{test="hello,gawk";print test}' # 内部变量赋值 awk -F: '{sex="male";print $1,sex,age;age=18}' /etc/passwd # 这里变量是先赋值再使用,从第二行才有age的值 cat awkscript {print script,$1,$2} awk -F: -f awkscript script="awk" /etc/passwd
范例:引用外部变量
[root@ali-bj-prod-web001 conf.d]# a=123 [root@ali-bj-prod-web001 conf.d]# awk 'BEGIN{print a}' [root@ali-bj-prod-web001 conf.d]# awk 'BEGIN{print '"$a"'}' 123 [root@ali-bj-prod-web001 conf.d]# awk "BEGIN{print "$a"}" 123 [root@ali-bj-prod-web001 conf.d]# awk BEGIN\{print\""$a"\"\} 123 user_bili=$(awk 'BEGIN{printf "%.2f\n", '$user_pv'/'$totoal_pv'*100}' )
动作 printf
printf 可以实现格式化输出
格式: printf "FORMAT", item1, item2, …
说明:
- 必须指定FORMAT
- 不会自动换行,需要显式给出换行控制符 \n
- FORMAT中需要分别为后面每个item指定格式符
格式符:与item一一对应
- %c:显示字符的ASCII码
- %d, %i:显示十进制整数
- %x %X 无符号以十六进制表示的整数
- %o 无符号以八进制表示的整数
- %e, %E:显示科学计数法数值
- %p 指针的值
- %f:显示为浮点数
- %g, %G:以科学计数法或浮点形式显示数值
- %s:显示字符串
- %u:无符号整数
- %%:显示%自身
修饰符
#[.#] 第一个数字控制显示的宽度;第二个#表示小数点后精度,如:%3.1f - 左对齐(默认右对齐) 如:%-15s + 显示数值的正负符号 如:%+d
范例:
awk -F: '{printf "%s",$1}' /etc/passwd awk -F: '{printf "%s\n",$1}' /etc/passwd awk -F: '{printf "%20s\n",$1}' /etc/passwd awk -F: '{printf "%-20s\n",$1}' /etc/passwd awk -F: '{printf "%-20s %10d\n",$1,$3}' /etc/passwd awk -F: '{printf "Username: %s\n",$1}' /etc/passwd awk -F: '{printf “Username: %sUID:%d\n",$1,$3}' /etc/passwd awk -F: '{printf "Username: %25sUID:%d\n",$1,$3}' /etc/passwd awk -F: '{printf "Username: %-25sUID:%d\n",$1,$3}' /etc/passwd
操作符
1)算术操作符:
x+y, x-y, x*y, x/y, x^y, x%y -x:转换为负数 +x:将字符串转换为数值
2)字符串操作符:没有符号的操作符,字符串连接 3)赋值操作符:
=, +=, -=, *=, /=, %=, ^=,++, --
范例:
[root@centos8 ~]#awk 'BEGIN{i=0;print i++,i}' 0 1 [root@centos8 ~]#awk 'BEGIN{i=0;print ++i,i}' 1 1
范例:
[root@centos8 ~]#awk -v n=0 '!n++' /etc/passwd # 真:结果为非0值,非空字符串。第一行!n为!0为1是真则打印,第二行!n为!2为0是假不打印,以此类推 root:x:0:0:root:/root:/bin/bash [root@centos8 ~]#awk -v n=0 '!n++{print n}' /etc/passwd 1 [root@centos8 ~]#awk -v n=1 '!n++{print n}' /etc/passwd # 永远为假则不打印 [root@centos8 ~]#awk -v n=0 '!++n{print n}' /etc/passwd [root@centos8 ~]#awk -v n=0 '!++n' /etc/passwd [root@centos8 ~]#awk -v n=-1 '!++n' /etc/passwd root:x:0:0:root:/root:/bin/bash
4)比较操作符:
==, !=, >, >=, <, <=
范例:
[root@centos8 ~]#awk 'NR==2' /etc/issue # 这是隐藏了{print $0} Kernel \r on an \m [root@centos8 ~]#awk -F: '$3>=1000' /etc/passwd nobody:x:65534:65534:Kernel Overflow User:/:/sbin/nologin wang:x:1000:1000:wang:/home/wang:/bin/bash cici:x:1001:1001::/home/cici:/bin/bash
范例:取奇,偶数行
[root@centos8 ~]#seq 10 | awk 'NR%2==0' 2 4 6 8 10 [root@centos8 ~]#seq 10 | awk 'NR%2==1' 1 3 5 7 9 [root@centos8 ~]#seq 10 | awk 'NR%2!=0' 1 3 5 7 9
5)模式匹配符:
~ 左边是否和右边匹配,包含关系
!~ 是否不匹配
范例:
[root@centos8 ~]#awk -F: '$0 ~ /root/{print $1}' /etc/passwd [root@centos8 ~]#awk -F: '$0 ~ "^root"{print $1}' /etc/passwd [root@centos8 ~]#awk '$0 !~ /root/' /etc/passwd [root@centos8 ~]#awk '/root/' /etc/passwd [root@centos8 ~]#awk -F: '$3==0' /etc/passwd [root@centos8 ~]#df | awk -F"[[:space:]]+|%" '$0 ~ /^\/dev\/sd/{print $5}' 5 1 92 [root@centos8 ~]#ifconfig eth0 | awk 'NR==2{print $2}' 10.0.0.8 $kube_CMD -n $namespace get pod |sed '1d'|awk '$(NF-3)~"0/" && $NF!~"(^[1-6]m|^[1-60]s)"{print $1}'
6)逻辑操作符:
与:&&,并且关系 或:||,或者关系 非:!,取反
范例:!取反
[root@centos8 ~]#awk 'BEGIN{print i}' [root@centos8 ~]#awk 'BEGIN{print !i}' 1 [root@centos8 ~]#awk -v i=10 'BEGIN{print !i}' 0 [root@centos8 ~]#awk -v i=-3 'BEGIN{print !i}' 0 [root@centos8 ~]#awk -v i=0 'BEGIN{print !i}' 1 [root@centos8 ~]#awk -v i=abc 'BEGIN{print !i}' 0 [root@centos8 ~]#awk -v i='' 'BEGIN{print !i}' 1
范例:
awk -F: '$3>=0 && $3<=1000 {print $1,$3}' /etc/passwd awk -F: '$3==0 || $3>=1000 {print $1,$3}' /etc/passwd awk -F: '!($3==0) {print $1,$3}' /etc/passwd awk -F: '!($3>=500) {print $1,$3}' /etc/passwd
7)条件表达式(三目表达式)
selector?if-true-expression:if-false-expression # selector为真执行第一个:否则第二个
范例:
awk -F: '{$3>=1000?usertype="Common User":usertype="SysUser";printf "%-20s:%12s\n",$1,usertype}' /etc/passwd
模式PATTERN
PATTERN:根据pattern条件,过滤匹配的行,再做处理
- 如果未指定:空模式,匹配每一行
范例:
[root@centos8 ~]#awk -F: '{print $1,$3}' /etc/passwd
/regular expression/:仅处理能够模式匹配到的行,需要用/ /括起来
范例:
[root@centos8 ~]#awk '/^UUID/{print $1}' /etc/fstab [root@centos8 ~]#awk '!/^UUID/{print $1}' /etc/fstab [root@centos8 ~]#df | awk '/^\/dev\/sd/' /dev/sda2 104806400 4935924 99870476 5% / /dev/sda3 52403200 398876 52004324 1% /data /dev/sda1 999320 848572 81936 92% /boot # 多条件: awk '/^(Sep 9|Sep 10).*(error|fail)/' testfile
- relational expression: 关系表达式,结果为“真”才会被处理真:结果为 非0值,非空字符串 假:结果为空字符串或0值
范例:
[root@centos8 ~]#awk '!1' /etc/passwd # !1后面隐藏了{print $0} [root@centos8 ~]#awk '!0' /etc/passwd root:x:0:0:root:/root:/bin/bash bin:x:1:1:bin:/bin:/sbin/nologin daemon:x:2:2:daemon:/sbin:/sbin/nologin adm:x:3:4:adm:/var/adm:/sbin/nologin ....... [root@centos8 ~]#awk '1' /etc/issue \S Kernel \r on an \m [root@centos8 ~]#awk '0' /etc/issue [root@centos8 ~]#awk '"me"' /etc/issue \S Kernel \r on an \m [root@centos8 ~]#awk '""' /etc/issue [root@centos8 ~]#awk 'me' /etc/issue [root@centos8 ~]#awk 'me' /etc/issue [root@centos8 ~]#awk -v me=wang 'me' /etc/issue \S Kernel \r on an \m [root@centos8 ~]#awk -v me="" 'me' /etc/issue [root@centos8 ~]#awk -v me="0" 'me' /etc/issue [root@centos8 ~]#awk -v me=0 'me' /etc/issue [root@centos8 ~]#awk '"0"' /etc/issue \S Kernel \r on an \m [root@centos8 ~]#awk '0' /etc/issue
范例:
awk -F: 'i=1;j=1{print i,j}' /etc/passwd #这里i=1隐藏了{print $0} Awk -F: '$3>=1000{print $1,$3}' /etc/passwd awk -F: '$3<1000{print $1,$3}' /etc/passwd awk -F: '$NF=="/bin/bash"{print $1,$NF}' /etc/passwd [root@centos8 ~]#awk -F: '$NF=="/bin/bash"{print $1,$NF}' /etc/passwd root /bin/bash wang /bin/bash cici /bin/bash [root@centos8 ~]#awk -F: '$NF ~ /bash$/{print $1,$NF}' /etc/passwd root /bin/bash wang /bin/bash cici /bin/bash
oline ranges:行范围
不支持直接用行号,但可以使用变量NR间接指定行号
/pat1/,/pat2/不支持直接给出数字格式
范例:
[root@centos8 ~]#seq 10 | awk 'NR>=3 && NR<=6' 3 4 5 6 [root@centos8 ~]#awk 'NR>=3 && NR<=6{print NR,$0}' /etc/passwd 3 daemon:x:2:2:daemon:/sbin:/sbin/nologin 4 adm:x:3:4:adm:/var/adm:/sbin/nologin 5 lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin 6 sync:x:5:0:sync:/sbin:/bin/sync [root@centos8 ~]#sed -n '3,6p' /etc/passwd daemon:x:2:2:daemon:/sbin:/sbin/nologin adm:x:3:4:adm:/var/adm:/sbin/nologin lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin sync:x:5:0:sync:/sbin:/bin/sync [root@centos8 ~]#awk '/^bin/,/^adm/' /etc/passwd bin:x:1:1:bin:/bin:/sbin/nologin daemon:x:2:2:daemon:/sbin:/sbin/nologin adm:x:3:4:adm:/var/adm:/sbin/nologin [root@centos8 ~]#sed -n '/^bin/,/^adm/p' /etc/passwd bin:x:1:1:bin:/bin:/sbin/nologin daemon:x:2:2:daemon:/sbin:/sbin/nologin adm:x:3:4:adm:/var/adm:/sbin/nologin
BEGIN/END模式
BEGIN{}:仅在开始处理文件中的文本之前执行一次
END{}:仅在文本处理完成之后执行一次
范例
awk -F : 'BEGIN {print "USER USERID"} {print $1":"$3} END{print "END FILE"}' /etc/passwd [root@ali-bj-prod-web001 ~]# awk -F : 'BEGIN {print "USER USERID"} {print $1":"$3} END{print "END FILE"}' /etc/passwd USER USERID root:0 ... ... rpc:32 END FILE awk -F: '{print "USER USERID";print $1":"$3} END{print "END FILE"}' /etc/passwd awk -F: 'BEGIN{print "USER UID \n--------------- "}{print $1,$3}' /etc/passwd awk -F: 'BEGIN{print "USER UID \n--------"}{print $1,$3}END{print "=========="}' /etc/passwd
范例:
seq 10 | awk 'i=0' seq 10 | awk 'i=1' seq 10 | awk 'i=!i' seq 10 | awk '{i=!i;print i}' seq 10 | awk '!(i=!i)' seq 10 | awk -v i=1 'i=!i' [root@centos8 ~]#seq 10 | awk 'i=0' [root@centos8 ~]#seq 10 | awk 'i=1' 1 2 3 4 5 6 7 8 9 10 [root@centos8 ~]#seq 10 | awk 'i=1' 1 2 3 4 5 6 7 8 9 10 [root@centos8 ~]#seq 10 | awk 'i=0' [root@centos8 ~]#seq 10 | awk 'i=!i' # 奇数行 1 3 5 7 9 [root@centos8 ~]#seq 10 | awk '!(i=!i)' # 偶数行 2 4 6 8 10 [root@centos8 ~]#seq 10 | awk -v i=1 'i=!i' 2 4 6 8 10 [root@centos8 ~]#seq 10 | awk -v i=0 'i=!i' 1 3 5 7 9 [root@centos8 ~]#seq 10 | awk '{i=!i;print i}' 1 0 1 0 1 0 1 0 1 0 [root@centos8 ~]#
条件判断 if-else
语法:
if(condition)statement # 单分支 if(condition){statement;…}[else statement] # 双分支 if(condition1){statement1}else if(condition2){statement2}else if(condition3){statement3}......else{statementN} # 多分支
使用场景:对awk取得的整行或某个字段做条件判断 范例:
awk -F: '{if($3>=1000)print $1,$3}' /etc/passwd awk -F: '{if($NF=="/bin/bash") print $1}' /etc/passwd awk '{if(NF>5) print $0}' /etc/fstab awk -F: '{if($3>=1000) {printf "Common user: %s\n",$1} else {printf "root or Sysuser: %s\n",$1}}' /etc/passwd awk -F: '{if($3>=1000) printf "Common user: %s\n",$1; else printf "root or Sysuser: %s\n",$1}' /etc/passwd df -h|awk -F% '/^\/dev\/sd/{print $1}'| awk '$NF>=80{print $1,$5}' # 分区利用率大于80%打印 df | awk -F"[[:space:]]+|%" '/^\/dev\/sd/{if($5>80)print $1,$5}' [root@centos8 ~]#df | awk -F' +|%' '/^\/dev\/sd/{if($5>=10)print $1,$5}' /dev/sda1 15 awk 'BEGIN{ test=100;if(test>90){print "very good"} else if(test>60){ print "good"}else{print "no pass"}}'
范例:文件上下行比较
文件内容:
{"localTime":"2016-10-25 16:22:00","protocol":101599,"version":2.26,"appType":3,"timestamp":1477383720000,"uuid":"FDF577D9-1B45-44E3-B2FC-F2BDE4A27C74","token":"a95b6bbe80b9457a9409420bd3ce8dce"}
[root@ali-bj-prod-web001 conf.d]# echo '{"localTime":"2016-10-25 16:22:00","protocol":101599,"version":2.26,"appType":3,"timestamp":1477383720000,"uuid":"FDF577D9-1B45-44E3-B2FC-F2BDE4A27C74","token":"a95b6bbe80b9457a9409420bd3ce8dce"}' |awk -F',+|:+' '{print $12}'
1477383720000
上下行比较
awk -F'[,:]+' 'BEGIN {t=0} {if ($12>t) {t =$12 b+=1} else {num+=1 }} END {print num,b}' logs/verification_log.log
switch语句
语法:
switch(expression) {case VALUE1 or /REGEXP/: statement1; case VALUE2 or /REGEXP2/: statement2; ...; default: statementn}
循环while
语法:
while (condition) {statement;…}
条件“真”,进入循环;条件“假”,退出循环 使用场景:
- 对一行内的多个字段逐一类似处理时使用
- 对数组中的各元素逐一处理时使用
示例:
#内置函数length()返回字符数,而非字节数 [root@centos8 ~]#awk 'BEGIN{print length("hello")}' 5 [root@centos8 ~]#awk 'BEGIN{print length("一条好汉")}' 4 # 打印/etc/grub2.cfg非空格开头后面包含linux16的单词长度 [root@centos7 ~]#awk '/^[[:space:]]*linux16/{i=1;while(i<=NF){print $i,length($i); i++}}' /etc/grub2.cfg linux16 7 /vmlinuz-3.10.0-1062.el7.x86_64 31 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 ro 2 crashkernel=auto 16 rhgb 4 quiet 5 net.ifnames=0 13 linux16 7 /vmlinuz-0-rescue-b12558570741487c9328c996e3265b09 50 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 ro 2 crashkernel=auto 16 rhgb 4 quiet 5 net.ifnames=0 13 [root@centos7 ~]#awk '/^[[:space:]]*linux16/{i=1;while(i<=NF){if(length($i)>=10){print $i,length($i)}; i++}}' /etc/grub2.cfg /vmlinuz-3.10.0-1062.el7.x86_64 31 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 crashkernel=auto 16 net.ifnames=0 13 /vmlinuz-0-rescue-b12558570741487c9328c996e3265b09 50 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 crashkernel=auto 16 net.ifnames=0 13 [root@centos8 ~]#awk 'BEGIN{ total=0;i=1;while(i<=100){total+=i;i++};print total}' 5050
循环 do-while
语法:
do {statement;…}while(condition)
意义:无论真假,至少执行一次循环体
do-while循环
语法:do {statement;…}while(condition)
意义:无论真假,至少执行一次循环体 范例:
[root@centos8 ~]#awk 'BEGIN{ total=0;i=1;do{ total+=i;i++;}while(i<=100);print total}'
5050
循环for
语法:
for(expr1;expr2;expr3) {statement;…}
常见用法:
for(variable assignment;condition;iteration process) {for-body}
特殊用法:能够遍历数组中的元素
for(var in array) {for-body}
范例:
[root@centos8 ~]#awk 'BEGIN{total=0;for(i=1;i<=100;i++){total+=i};print total}'
5050
范例:
[root@centos7 ~]#awk '/^[[:space:]]*linux16/{for(i=1;i<=NF;i++) {print $i,length($i)}}' /etc/grub2.cfg linux16 7 /vmlinuz-3.10.0-1062.el7.x86_64 31 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 ro 2 crashkernel=auto 16 rhgb 4 quiet 5 net.ifnames=0 13 linux16 7 /vmlinuz-0-rescue-b12558570741487c9328c996e3265b09 50 root=UUID=bebb9244-bbb8-4c69-9249-54a36c75155e 46 ro 2 crashkernel=auto 16 rhgb 4 quiet 5 net.ifnames=0 13
性能比较
time (awk 'BEGIN{ total=0;for(i=0;i<=10000;i++){total+=i;};print total;}') time (total=0;for i in {1..10000};do total=$(($total+i));done;echo $total) time (for ((i=0;i<=10000;i++));do let total+=i;done;echo $total) time (seq –s ”+” 10000|bc)
continue和break
continue 中断本次循环 break 中断整个循环 格式:
continue [n] break [n]
范例:
[root@centos8 ~]#awk 'BEGIN{sum=0;for(i=1;i<=100;i++){if(i%2==0)continue;sum+=i}print sum}' 2500 [root@centos8 ~]#awk 'BEGIN{sum=0;for(i=1;i<=100;i++){if(i==50)break;sum+=i}print sum}' 1225
next
next 可以提前结束对本行处理而直接进入下一行处理(awk自身循环) 范例:
[root@centos8 ~]#awk -F: '{if($3%2!=0) next; print $1,$3}' /etc/passwd # 只处理gid偶数的内容 root 0 daemon 2 lp 4 shutdown 6 mail 8 games 12 ftp 14 nobody 65534 polkitd 998 gluster 996 rtkit 172 rpc 32 chrony 994 saslauth 992 clevis 984 pegasus 66 colord 982 setroubleshoot 980 gdm 42 gnome-initial-setup 978 sshd 74 avahi 70 tcpdump 72 wang 1000
数组
awk的数组为关联数组 格式
array_name[index-expression]
范例:
weekdays["mon"]="Monday"
index-expression
- 利用数组,实现 k/v 功能
- 可使用任意字符串;字符串要使用双引号括起来
- 如果某数组元素事先不存在,在引用时,awk会自动创建此元素,并将其值初 始化为“空串”
- 若要判断数组中是否存在某元素,要使用“index in array”格式进行遍历
范例:
[root@centos8 ~]#awk 'BEGIN{weekdays["mon"]="Monday";weekdays["tue"]="Tuesday";print weekdays["mon"]}'
Monday
范例:
awk '!line[$0]++' dupfile # 去重 awk '{!line[$0]++;print $0, line[$0]}' dupfile
范例:判断数组索引是否存在
[root@centos8 ~]# awk 'BEGIN{array["i"]="x"; array["j"]="y" ; print "i" inarray, "y" in array }' 1 0 [root@centos8 ~]#awk 'BEGIN{array["i"]="x"; array["j"]="y" ;if ("i" in array ){print "存在"}else{print "不存在"}}' 存在 [root@centos8 ~]#awk 'BEGIN{array["i"]="x"; array["j"]="y" ;if ("abc" in array ){print "存在"}else{print "不存在"}}' 不存在
若要遍历数组中的每个元素,要使用for循环
for(var in array) {for-body}
注意:var会遍历array的每个索引
范例:遍历数组
[root@centos8 ~]#awk 'BEGIN{weekdays["mon"]="Monday";weekdays["tue"]="Tuesday";for(i in weekdays) {print weekdays[i]}}' Tuesday Monday [root@centos8 ~]#awk 'BEGIN{students[1]="daizong";students[2]="junzong";students[3]="kunzong";for(x in students){print x":"students[x]}}' 1:daizong 2:junzong 3:kunzong [root@centos8 ~]#awk 'BEGIN { a["x"] = "welcome" a["y"] = "to" a["z"] = "me" for (i in a) { print i,a[i] } }' x welcome y to z me [root@centos8 ~]#awk -F: '{user[$1]=$3}END{for(i in user){print "username: "i,"uid: "user[i]}}' /etc/passwd username: adm uid: 3 username: rpc uid: 32 username: dnsmasq uid: 985 username: radvd uid: 75 username: sync uid: 5 username: mail uid: 8 username: exim uid: 93 username: tss uid: 59 username: gluster uid: 996 username: unbound uid: 995 username: halt uid: 7
范例:显示主机的连接状态出现的次数
[root@centos8 ~]#awk 'NR!=1{print $1}' ss.log |sort |uniq -c 118 ESTAB 1 FIN-WAIT-1 11 LAST-ACK [root@centos8 ~]#cat ss.log | sed -nr '1!s/^([^0-9]+) .*/\1/p'|sort |uniq -c 529 ESTAB 9 LISTEN 128 SYN-RECV 95 TIME-WAIT [root@centos8 ~]#ss -ant | awk 'NR!=1{state[$1]++}END{for(i in state){printi,state[i]}}' SYN-RECV 128 LISTEN 9 ESTAB 529 TIME-WAIT 95 [root@centos8 ~]#netstat -tan | awk '/^tcp/{state[$NF]++}END{for(i in state){print i,state[i]}}' LISTEN 9 SYN_RECV 126 ESTABLISHED 523 FIN_WAIT2 40
范例:访问日志ip排序
[root@centos8 ~]#awk '{ip[$1]++}END{for(i in ip){print i,ip[i]}}' /var/log/httpd/access_log 172.20.0.200 1482 172.20.21.121 2 172.20.30.91 29 172.16.102.29 864 172.20.0.76 1565 172.20.9.9 15 172.20.1.125 463 172.20.61.11 2 172.20.73.73 198 [root@centos8 ~]#awk '{ip[$1]++}END{for(i in ip){print ip[i],i}}' access_log|sort -nr| head -3 4870 172.20.116.228 3429 172.20.116.208 2834 172.20.0.222 [root@centos8 ~]#awk '{ip[$1]++}END{for(i in ip){print i,ip[i]}}' access_log|sort -k2 -nr|head -3 172.20.116.228 4870 172.20.116.208 3429 172.20.0.222 2834
范例:封掉查看访问日志中连接次数超过1000次的IP
[root@centos8 ~]#awk '{ip[$1]++}END{for(i in ip){if(ip[i]>=1000){system("iptables -A INPUT -s "i" -j REJECT")}}}' nginx.access.log-20200428
范例:多维数组
[root@centos8 ~]#awk 'BEGIN{
> array[1][1]=11
> array[1][2]=12
> array[1][3]=13
> array[2][1]=21
> array[2][2]=22
> array[2][3]=23
> for (i in array)
> for (j in array[i])
> print array[i][j]
> }'
11
12
13
21
22
23
awk函数
awk 的函数分为内置和自定义函数
常见内置函数
数值处理:
rand():返回0和1之间一个随机数 srand():配合rand() 函数,生成随机数的种子 int():返回整数*
范例:随即数
[root@centos8 ~]#awk 'BEGIN{srand();print rand()}' 0.790437 [root@centos8 ~]#awk 'BEGIN{srand();print rand()}' 0.283736 [root@centos8 ~]#awk 'BEGIN{srand();print rand()}' 0.948082 [root@centos8 ~]#awk 'BEGIN{srand();print rand()}' 0.371798 [root@centos8 ~]#awk 'BEGIN{srand(); for (i=1;i<=10;i++)print int(rand()*100)}' 35 17 35 95 19 15 70 54 46 93
字符串处理:
- length([s]):返回指定字符串的长度
- sub(r,s,[t]):对t字符串搜索r表示模式匹配的内容,并将第一个匹配内容替换为s
范例:
[root@centos8 ~]#echo "2008:08:08 08:08:08" | awk 'sub(/:/,"-",$1)' 2008-08:08 08:08:08 [root@centos8 ~]#echo "2008:08:08 08:08:08" | awk '{sub(/:/,"-",$1);print $0}' 2008-08:08 08:08:08
gsub(r,s,[t]):对t字符串进行搜索r表示的模式匹配的内容,并全部替换为s所表示的内容
范例:
[root@centos8 ~]#echo "2008:08:08 08:08:08" | awk 'gsub(/:/,"-",$0)' 2008-08-08 08-08-08 [root@centos8 ~]#echo "2008:08:08 08:08:08" | awk '{gsub(/:/,"-",$0);print $0}' 2008-08-08 08-08-08
split(s,array,[r]):以r为分隔符,切割字符串s,并将切割后的结果保存至 array所表示的数组中,第一个索引值为1,第二个索引值为2,…
范例:
[root@centos8 ~]#netstat -tn | awk '/^tcp/{split($5,ip,":");count[ip[1]]++}END{for(i in count){print i,count[i]}}' 10.0.0.1 1 10.0.0.6 1 10.0.0.7 673 链接状态检查: ss -ant | awk '{name[$1]++}END{for(n in name)print n,name[n]}' 当前访问IP ss -an | awk '{split($NF,A,":");a[A[1]]++}END{for(i in a) print i,a[i]}' |grep '^[0-9]' |sort -nr -k2,2 结合产品 [root@hd-test-all-01 nhd_server]# netstat -n |grep '^tcp' |tail -n1 tcp 0 0 ::ffff:192.168.1.150:3306 ::ffff:192.168.1.150:40712 ESTABLISHED [root@hd-test-all-01 nhd_server]# netstat -n |grep '^tcp' |head -n1 tcp 0 0 192.168.1.150:6379 192.168.1.150:46096 ESTABLISHED [root@hd-test-all-01 nhd_server]# netstat -n | awk '/^tcp/ {n=split($(NF-1),array,":"); if(n<=2) IP[array[1]]++; else IP[array[4]]++; stat[$NF]++; ++snum} END {for(i in IP){printf("%-20s %s\n", i, IP[i]); num++}printf("%-20s %s\n","TOTAL_IP",num); for(s in stat)printf("%-20s %s\n",s, stat[s]); printf("%-20s %s\n","TOTAL_LINK",snum);}' |tail -n10 192.168.1.35 1 192.168.1.100 4 192.168.1.26 2 192.168.1.44 30 TOTAL_IP 36 TIME_WAIT 65 CLOSE_WAIT 1 FIN_WAIT2 5 ESTABLISHED 1138 TOTAL_LINK 1209
system 函数:可以awk中调用shell命令
空格是awk中的字符串连接符,如果system中需要使用awk中的变量可以使用空格 分隔,或者说除了awk的变量外其他一律用”“引用起来
awk 'BEGIN{system("hostname")}' awk 'BEGIN{score=100; system("echo your score is " score) }' [root@centos8 ~]#netstat -tn | awk '/^tcp/{split($5,ip,":");count[ip[1]]++}END{for(i in count){if(count[i]>=10){system("iptables -A INPUT -s "i" -j REJECT")}}}'
mktime( YYYY MM DD HH MM SS[ DST]) 生成时间格式
strftime([format [, timestamp]]) 格式化时间输出,将时间戳转为时间字符 串 systime()得到时间戳,返回从1970年1月1日开始到当前时间(不计闰年)的整 秒数
strftime时间函数
%a 星期几的缩写(Sun) %A 星期几的完整写法(Sunday) %b 月名的缩写(Oct) %B 月名的完整写法(October) %c 本地日期和时间 %d 十进制日期 %D 日期 08/20/99 %e 日期,如果只有一位会补上一个空格 %H 用十进制表示24小时格式的小时 %I 用十进制表示12小时格式的小时 %j 从1月1日起一年中的第几天 %m 十进制表示的月份 %M 十进制表示的分钟 %p 12小时表示法(AM/PM) %S 十进制表示的秒 %U 十进制表示的一年中的第几个星期(星期天作为一个星期的开始) %w 十进制表示的星期几(星期天是0) %W 十进制表示的一年中的第几个星期(星期一作为一个星期的开始) %x 重新设置本地日期(08/20/99) %X 重新设置本地时间(12:00:00) %y 两位数字表示的年(99) %Y 当前月份 %Z 时区(PDT) %% 百分号(%)
范例:
[root@centos7 ~]# awk 'BEGIN{print strftime("%x",systime())}' 2016年01月06日 [root@centos7 ~]# awk 'BEGIN{print strftime("%x-%X",systime())}' 2016年01月06日-13时58分00秒 [root@centos7 ~]# awk 'BEGIN{print strftime("%y-%m-%d %H:%M:%S",systime())}' 16-01-06 13:59:58 [root@ali-bj-prod-web001 conf.d]# awk 'BEGIN{tstamp=mktime("2021 02 28 6 12 12");print tstamp;}' 1614463932 [root@ali-bj-prod-web001 conf.d]# awk 'BEGIN{tstamp=mktime("2021 02 28 6 12 12");print strftime("%c",tstamp);}' Sun 28 Feb 2021 06:12:12 AM CST # 时间差 [root@ali-bj-prod-web001 conf.d]# awk 'BEGIN{tstamp1=mktime("2021 02 28 6 12 12");tstamp2=systime();print tstamp2-tstamp1;}' 87583
字符串大小写转换tolower(var) toupper(var)
[root@centos7 ~]# name=AbC [root@centos7 ~]# echo ${name^^} ABC [root@centos7 ~]# echo ${name,,} abc [root@centos7 ~]# echo $name | tr 'a-z' 'A-Z' ABC [root@centos7 ~]# awk 'BEGIN{a="abcDEF";print a}' abcDEF [root@centos7 ~]# awk 'BEGIN{a="abcDEF";print tolower(a)}' abcdef [root@centos7 ~]# awk 'BEGIN{a="abcDEF";print toupper(a)}' ABCDEF
刷新输出缓冲区fflush函数
范例:
[root@nginx01 ~]# tail -n +$(tail -n1 /root/n) -F /root/ip.txt 2>&1 | awk 'ARGIND==1{i=$0;next}{i++;if($0~/^tail/){i=0};print $0;print i >> "/root/n";fflush("")}' /root/n -
如,flume日志收集中设置断点收集
a1.sources.r1.type = exec
a1.sources.r1.shell = /bin/bash -c
a1.sources.r1.command = tail -n +$(tail -n1 /home/hadoop/flume_read/m) -F /home/hadoop/student.txt | awk 'ARGIND==1{i=$0;next}{i++;if($0~/^tail/){i=0};print
$0;print i >> "/home/hadoop/flume_read/m";fflush("")}' /home/hadoop/flume_read/m -
fflush函数用以刷新输出缓冲区,如果没有参数,就刷新标准输出的缓冲区,如果以空字符串为参数,如fflush(""),则刷新所有文件和管道的输出缓冲区。
这里的fflush是向n文件中写入
其他参考: linux awk 内置函数详细介绍(实例)http://blog.chinaunix.net/uid-21505614-id-289434.html
自定义函数
自定义函数格式:
function name ( parameter, parameter, ... ) { statements return expression }
范例:
[root@centos8 ~]#cat func.awk # x,y 为形式参数 function max(x,y) { x>y?var=x:var=y return var } BEGIN{print max(a,b)} [root@centos8 ~]#awk -v a=30 -v b=20 -f func.awk # a,b 为实际参数 30
awk脚本
将awk程序写成脚本,直接调用或执行 范例:
[root@centos8 ~]#cat passwd.awk
{if($3>=1000)print $1,$3}
[root@centos8 ~]#awk -F: -f passwd.awk /etc/passwd
nobody 65534
wang 1000
me 1001
范例:
[root@centos8 ~]#cat test.awk #!/bin/awk -f #this is a awk script {if($3>=1000)print $1,$3} [root@centos8 ~]#chmod +x test.awk [root@centos8 ~]#./test.awk -F: /etc/passwd nobody 65534 wang 1000 me 1001
向awk脚本传递参数 格式:
awkfile var=value var2=value2... Inputfile
注意:在BEGIN过程中不可用。直到首行输入完成以后,变量才可用。可以通过-v参 数,让awk在执行BEGIN之前得到变量的值。命令行中每一个指定的变量都需要一 个-v参数
范例:
[root@centos8 ~]#cat test2.awk #!/bin/awk -f {if($3 >=min && $3<=max)print $1,$3} [root@centos8 ~]#chmod +x test2.awk [root@centos8 ~]#./test2.awk -F: min=100 max=200 /etc/passwd systemd-resolve 193 rtkit 172 pulse 171 qemu 107 usbmuxd 113 abrt 173
练习
- 文件host_list.log如下格式,请提取”.me.com”前面的主机名部分并
写入到回到该文件中
1 www.me.com 2 blog.me.com 3 study.me.com 4 linux.me.com 5 python.me.com ...... 999 study.me.com
- 统计/etc/fstab文件中每个文件系统类型出现的次数
- 统计/etc/fstab文件中每个单词出现的次数
- 提取出字符串Yd$C@M05MB%9&Bdh7dq+YVixp3vpw中的所有数字
- 有一文件记录了1-100000之间随机的整数共5000个,存储的格式 100,50,35,89…请取出其中最大和最小的整数
- 解决Dos攻击生产案例:根据web日志或者或者网络连接数,监控当某个IP并发 连接数或者短时内PV达到100,即调用防火墙命令封掉对应的IP,监控频率每 隔5分钟。防火墙命令为:iptables -A INPUT -s IP -j REJECT
- 将以下文件内容中FQDN取出并根据其进行计数从高到低排序
http://mail.me.com/index.html http://www.me.com/test.html http://study.me.com/index.html http://blog.me.com/index.html http://www.me.com/images/logo.jpg http://blog.me.com/20080102.html http://www.me.com/images/me.jpg
参考答案:
[root@centos8 ~]#awk -F"/" '{url[$3]++}END{for(i in url){print url[i],i}}' url.log |sort -nr 3 www.me.com 2 blog.me.com 1 study.me.com 1 mail.me.com
8、将以下文本以inode为标记,对inode相同的counts进行累加,并且统计出同一inode中, beginnumber的最小值和endnumber的最大值
inode|beginnumber|endnumber|counts| 106|3363120000|3363129999|10000| 106|3368560000|3368579999|20000| 310|3337000000|3337000100|101| 310|3342950000|3342959999|10000| 310|3362120960|3362120961|2| 311|3313460102|3313469999|9898| 311|3313470000|3313499999|30000| 311|3362120962|3362120963|2|
输出的结果格式为:
310|3337000000|3362120961|10103| 311|3313460102|3362120963|39900| 106|3363120000|3368579999|30000|
范例:高效的日志分析命令
# 1. 快速定位错误日志 grep -E "ERROR|WARN|FATAL" /var/log/app.log | tail -100 # 2. 统计错误频率 awk '/ERROR/ {print $1,$2}' app.log | uniq -c | sort -rn # 3. 分析访问日志 # 统计状态码分布 awk '{print $9}' access.log | sort | uniq -c | sort -rn # 统计慢请求 awk '$NF > 1000 {print $7,$NF}' access.log | sort -k2 -rn | head # 4. 实时日志监控 tail -f /var/log/messages | grep --line-buffered ERROR # 5. 多文件日志合并分析 zcat /var/log/app.log*.gz | grep ERROR | less